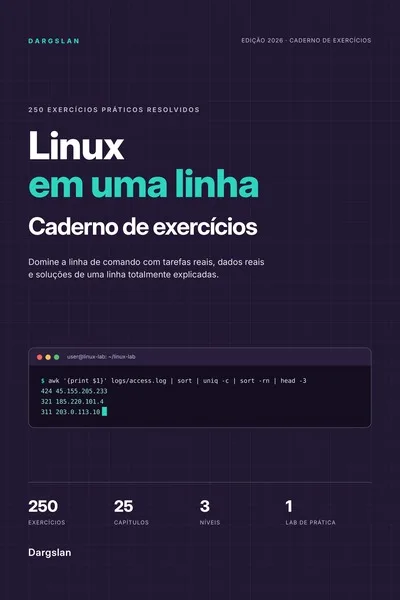
Linux en una línea
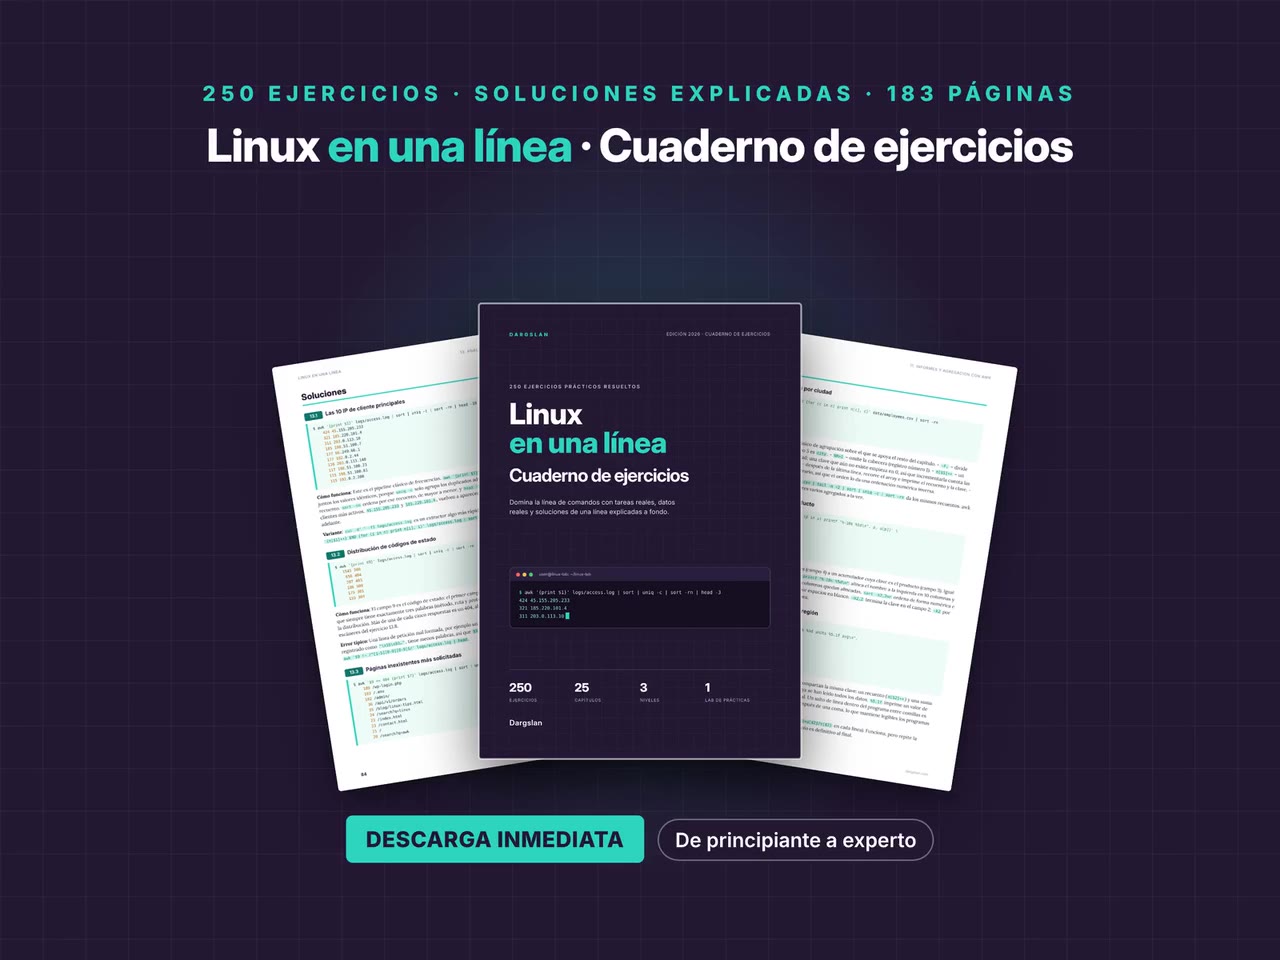
Cuaderno de ejercicios: 250 ejercicios prácticos con soluciones explicadas
What's Included:
At a Glance
Linux en una línea is a professional Linux Fundamentals eBook by Dargslan, available as an instant PDF and EPUB download for €13.90, DRM-free and yours to keep, with free updates. Cuaderno de ejercicios: 250 ejercicios prácticos con soluciones explicadas.
- Format: PDF and EPUB (instant download)
- Language: es
- Topic: Linux Fundamentals
- Edition: 1st Edition
- Price: €13.90
Key Highlights
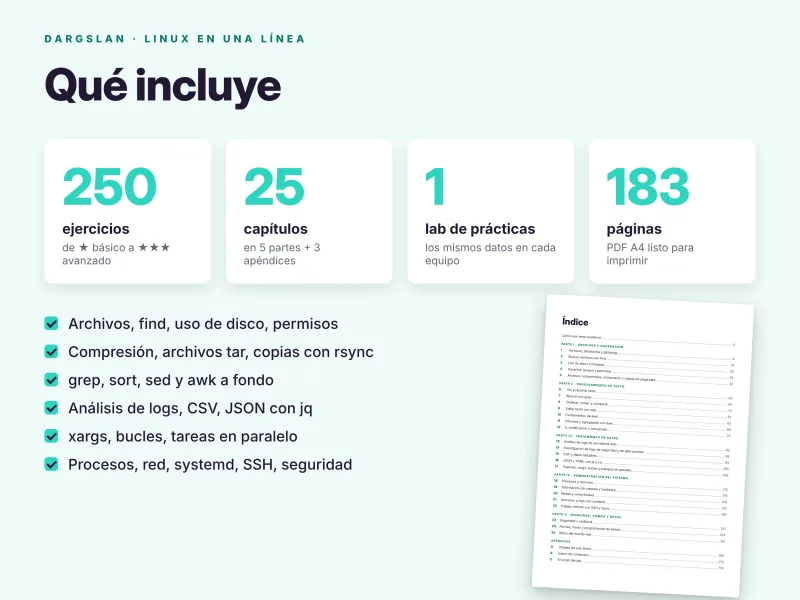
- 183 páginas, 250 ejercicios en 25 capítulos y 5 partes
- Completamente en español; comandos, salidas y datos del lab en inglés, como en la vida real
- Cada solución en una sola línea, con su salida real
- Explicaciones opción por opción, con variantes y errores típicos
- Tres niveles de dificultad en cada capítulo: básico, intermedio y avanzado
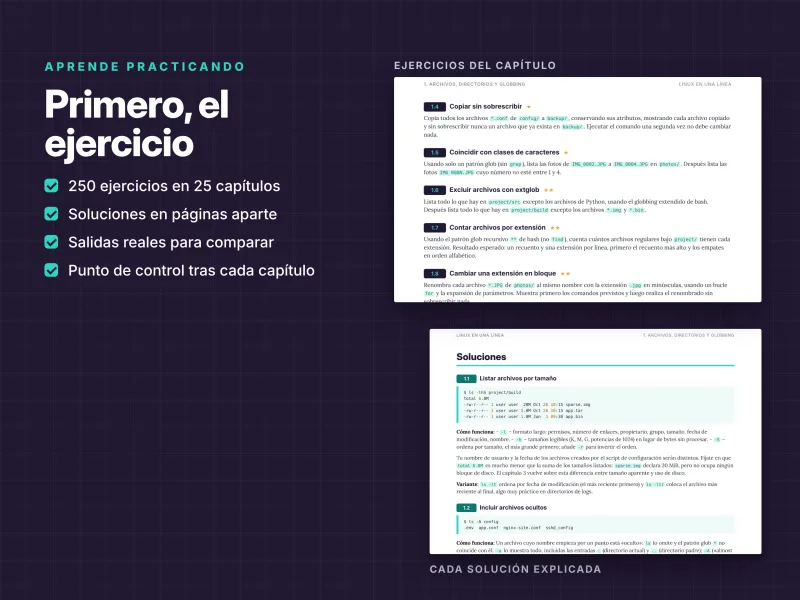
- Soluciones en páginas aparte, para que lo intentes tú primero
- Script del lab con logs web, de SSH y de aplicación, CSV, JSON y archivos de configuración
- Datos deterministas: tu salida coincide exactamente con el libro
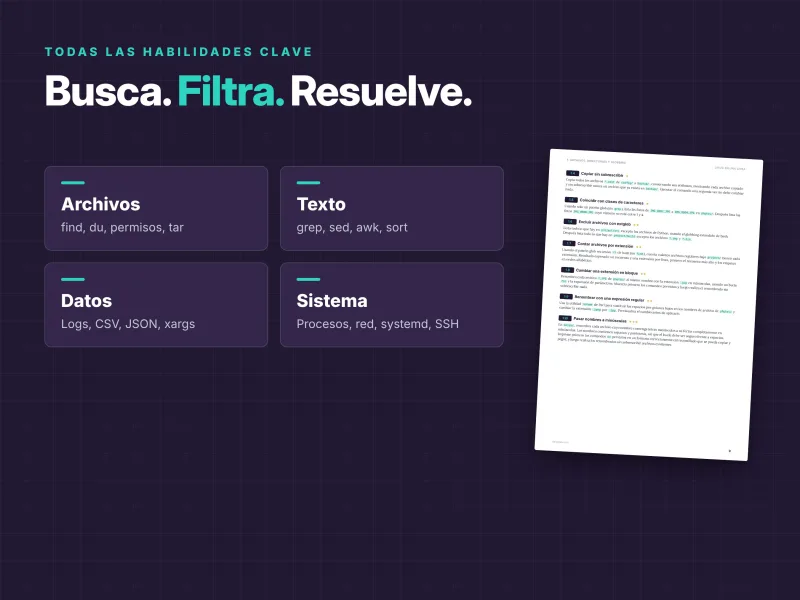
- grep, sed, awk, find, xargs, jq, yq, datamash, rsync, systemd y más
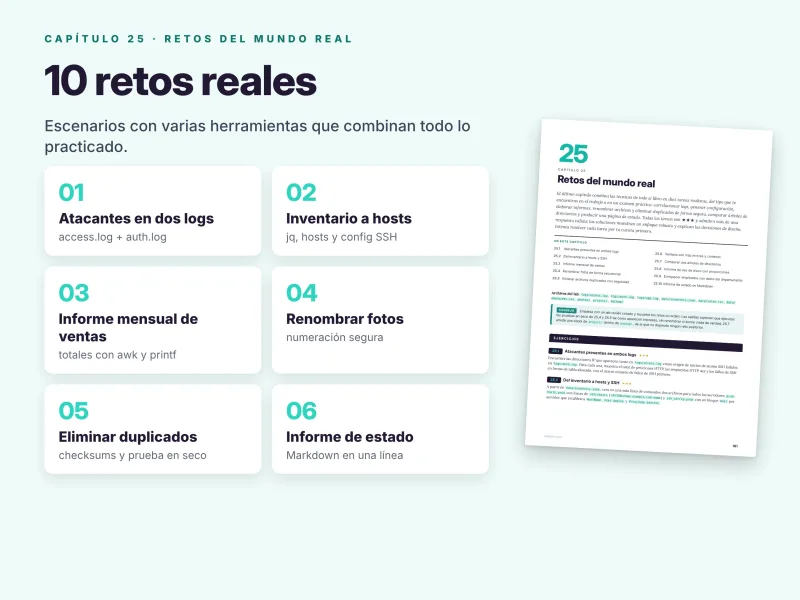
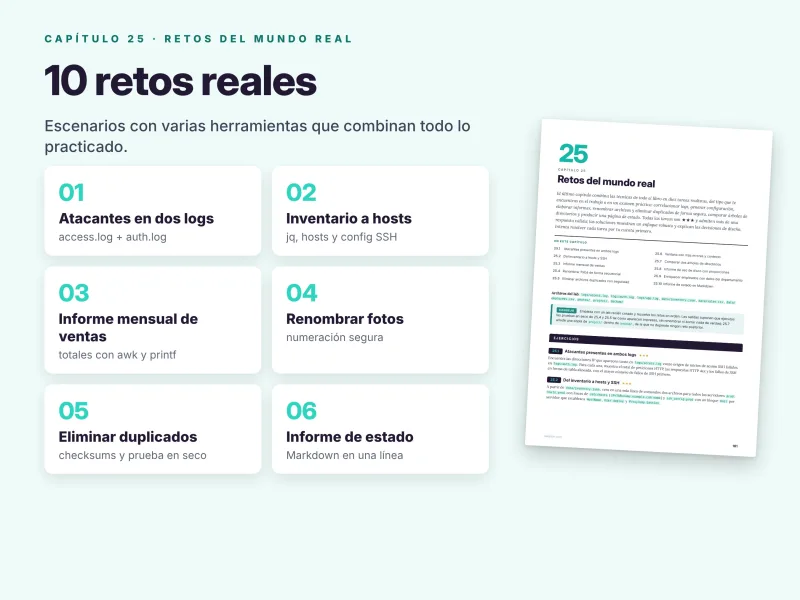
- 10 retos del mundo real que lo combinan todo
- Probado en Debian 13, Ubuntu 26.04 LTS y la familia RHEL 10
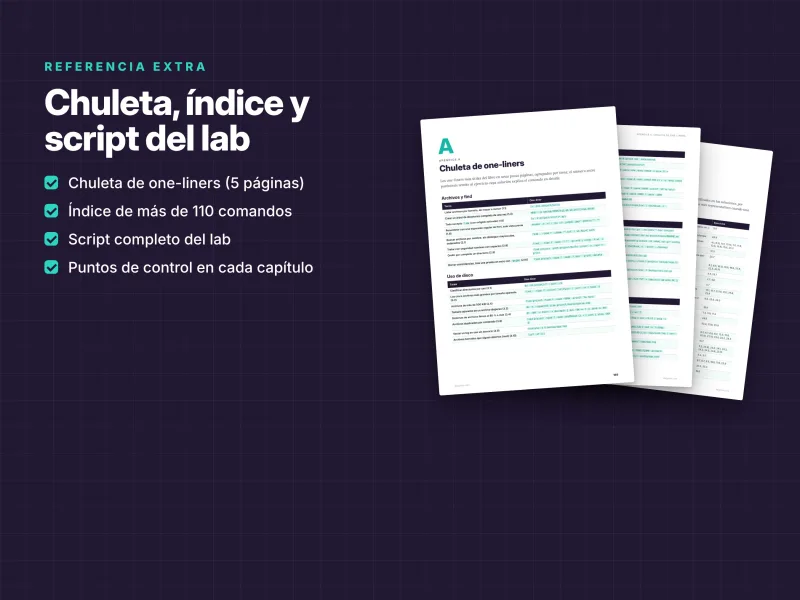
- Chuleta de 5 páginas e índice de más de 110 comandos
- PDF + EPUB + script del lab + todas las soluciones en un ZIP
Overview
Domina la línea de comandos de Linux practicando, en español: 250 ejercicios, cada uno resuelto con un one-liner explicado opción por opción, sobre un lab con logs, CSV, JSON y archivos de configuración reales. 183 páginas. PDF + EPUB + lab + ZIP.
The Problem
Muchos usuarios de Linux conocen los nombres de las herramientas clásicas (grep, sed, awk, find, xargs), pero siguen copiando comandos del buscador en cuanto surge una pregunta real. Los tutoriales explican las opciones de forma aislada, con ejemplos de juguete, y rara vez muestran cómo combinar herramientas en un pipeline que responda algo útil: quién está atacando el servidor, qué servicio falla, qué archivos están duplicados.
Sin datos realistas con los que practicar y sin explicaciones de por qué funciona un comando, el conocimiento nunca se convierte en soltura, y cada tarea nueva empieza de cero. Además, casi todo el material de práctica que existe está en inglés.
The Solution
Linux en una línea construye la soltura a base de práctica, en español: 250 ejercicios en 25 capítulos, cada uno resuelto con un único comando de una línea y explicado opción por opción, con su salida real, variantes y errores típicos.
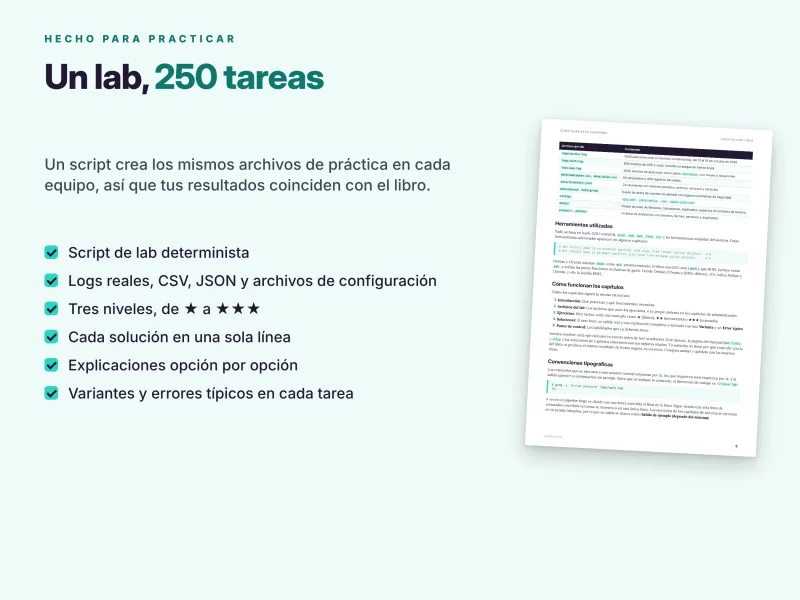
Un script crea un lab de prácticas determinista con logs de servidor web, de SSH y de aplicación, datos CSV y JSON, archivos de configuración y árboles de archivos desordenados, para que tus resultados coincidan exactamente con el libro. Avanzas desde los archivos y find, pasando por grep, sed y awk, hasta el análisis de logs, jq y yq, xargs y los trabajos en paralelo, la administración del sistema, las auditorías de seguridad y diez retos del mundo real. Una chuleta de 5 páginas y un índice de más de 110 comandos lo mantienen útil mucho después de terminarlo.
About This Book
Linux en una línea — Cuaderno de ejercicios: 250 ejercicios prácticos con soluciones explicadas
Leer sobre la línea de comandos no es lo mismo que usarla. Puedes saber qué hacen grep, awk, sed y find y aun así quedarte en blanco cuando llega una pregunta real: qué direcciones IP machacaron anoche el servidor SSH, qué servicio genera más errores, qué archivos de este árbol están duplicados, qué certificado caduca primero. La soltura llega con la práctica: resolver tareas reales, sobre datos reales, hasta que unir pequeñas herramientas con pipes se convierta en algo natural. Linux en una línea te da exactamente esa práctica.
Este cuaderno de ejercicios de 183 páginas, escrito íntegramente en español, contiene 250 ejercicios prácticos, y cada solución es un one-liner: un comando completo en una sola línea, normalmente un pipeline, que puedes escribir, ejecutar, modificar y reutilizar. Después de cada bloque de ejercicios encontrarás las soluciones con su salida real y una explicación precisa de cada opción, patrón y tubería, a menudo con una variante y un error típico. Aprendes los comandos y, además, aprendes a pensar en pequeñas herramientas unidas mediante pipes.
Un lab de prácticas que coincide exactamente con el libro
La mayoría de los ejercicios trabajan sobre el mismo conjunto de archivos realistas, creados por un único script, setup-lab.sh, que se incluye como descarga aparte y se reproduce íntegramente en el apéndice C. Un solo comando monta el lab en ~/linux-lab:
logs/access.log: 3000 peticiones web en formato combined log;logs/auth.log: 800 eventos de SSH y sudo, incluido un ataque de fuerza bruta;logs/app.log: 2000 eventos de aplicación como pareskey=value, con niveles y duraciones;data/employees.csvydata/sales.csv: 60 empleados y 400 registros de ventas;data/inventory.json: 24 servidores con sistema operativo, entorno, recursos y servicios;- archivos
passwdygroupde ejemplo con algunos problemas de seguridad, archivos de configuración comosshd_config,.envy un sitio de nginx, una carpetamessy/con finales de línea de Windows, tabuladores, duplicados y espacios en los nombres de archivo, y árboles de proyecto y de fotos con tamaños, fechas, permisos y duplicados.
Los datos se generan de forma determinista, de modo que cada lector obtiene archivos idénticos byte a byte y tu salida coincide con la que aparece impresa en el libro. Volver a crear el lab tarda un segundo, así que puedes empezar cada capítulo desde cero, incluso después de una edición con sed -i o una limpieza con find -delete. Como en la vida real, los comandos, las salidas de los programas y los datos de práctica están en inglés; las explicaciones, en español.
Probado en Linux actual, funciona casi en cualquier parte
Todo se basa en bash, GNU coreutils, grep, sed, awk, find, tar y las herramientas estándar del sistema. El cuaderno se ha probado en Debian 13, Ubuntu 26.04 LTS y la familia RHEL 10 (AlmaLinux, Rocky Linux), y funciona en cualquier sistema Linux actual, en una máquina virtual, en WSL o en un contenedor. Algunos capítulos usan herramientas adicionales (gawk, jq, yq, datamash, GNU parallel, zstd, rsync, sqlite3, dos2unix y otras), y los comandos de instalación se indican tanto para apt como para dnf. Como Debian y Ubuntu instalan mawk como awk predeterminado, el libro explica la diferencia y señala las pocas funciones exclusivas de GNU awk.
Parte I: Archivos y navegación
Empiezas donde todo administrador pasa el día: el sistema de archivos. Trabajas con archivos, directorios y globbing, el renombrado masivo y los nombres con espacios que rompen tantos scripts. El capítulo de find cubre nombres, tamaños, fechas, permisos, expresiones regulares, cómo saltarse directorios enteros, -exec y el borrado seguro de archivos de copia de seguridad. Mides el uso de disco, localizas los archivos más grandes, los archivos dispersos y los duplicados, y haces limpieza. Inspeccionas usuarios, grupos y permisos y creas archivos comprimidos con compresión, sumas de comprobación e instantáneas con rsync.
Parte II: Procesamiento de texto
Este es el corazón de la línea de comandos. Ves y recortas texto con head, tail, cut y sed -n, buscas con grep y ripgrep usando expresiones regulares, y ordenas, cuentas, comparas y unes archivos. El capítulo de sed edita archivos de configuración de forma segura: sustituir cadenas en todas partes, borrar rangos, eliminar comentarios y líneas en blanco, reordenar con grupos, corregir finales de línea CRLF en el propio archivo con copia de seguridad, descomentar una directiva y cambiar un valor en una sola sección. Dos capítulos de awk te llevan de los campos y patrones a los informes, la agregación por grupos y las uniones. Un capítulo sobre tr, codificación y conversión trata los finales de línea, Base64, el hexadecimal y el formato de los números.
Parte III: Tratamiento de datos
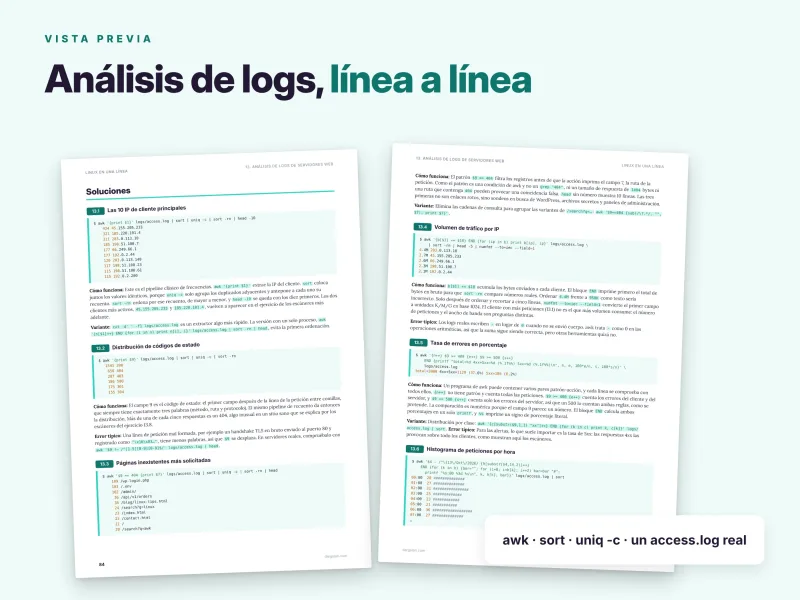
Ahora respondes preguntas reales a partir de datos reales. Analizas logs de servidores web: las IP de cliente más activas, la distribución de los códigos de estado, las páginas inexistentes más solicitadas, el tráfico por IP, las tasas de error, un histograma de peticiones por hora, bots frente a personas, escáneres de vulnerabilidades, el minuto de más actividad y los visitantes únicos por día. Investigas logs de seguridad y de aplicaciones: atacantes por fuerza bruta, los nombres de usuario que prueban, el uso de sudo, los errores por servicio, las peticiones más lentas y los percentiles de tiempo de respuesta. Procesas CSV y datos tabulares con awk, datamash y one-liners de SQLite, consultas y transformas JSON y YAML con jq y yq (incluido generar líneas de /etc/hosts y convertir JSON a YAML) y dominas las tuberías, xargs, los bucles y los trabajos en paralelo, incluidos los nombres con espacios, la entrada vacía, tee, los arrays, la detección de fallos dentro de un pipeline y la compresión de archivos en paralelo.
Parte IV: Administración del sistema
Estos capítulos se ejecutan en tu propia máquina, por lo que su salida se marca como salida de ejemplo que depende del sistema. En procesos y recursos encuentras los procesos que más memoria y CPU consumen, cuentas procesos por usuario, muestras un árbol de procesos, detienes procesos por nombre con seguridad, liberas un puerto ocupado, limitas el tiempo de ejecución y la prioridad, comparas la carga con el número de núcleos, inspeccionas un proceso en /proc y encuentras zombis y sus padres. Información del sistema y hardware cubre un resumen del sistema operativo y del kernel, la CPU y la memoria, el tiempo de actividad y la hora de arranque, los discos y particiones, si hace falta reiniciar, los dispositivos PCI y USB, la detección de virtualización y los paquetes instalados más grandes.
Compruebas las redes y la conectividad: interfaces, la puerta de enlace predeterminada, DNS directo e inverso, tu IP pública, los puertos en escucha con sus procesos, las conexiones por IP remota, la prueba de un puerto TCP, el código de estado y los tiempos HTTP, la velocidad de descarga y la caducidad de los certificados TLS. Con systemd y sus logs listas las unidades fallidas y los servicios habilitados, lees los logs desde un momento dado, encuentras los errores del arranque actual y del anterior, ves los temporizadores y su próxima ejecución, limpias el espacio en disco del journal, localizas las unidades más ruidosas y detectas los servicios que se han reiniciado. Trabajo remoto con SSH y rsync cubre las huellas de las claves, las entradas de known_hosts, la instalación de tu clave pública, ejecutar un comando en muchos hosts, reflejar directorios con rsync, transmitir tar por SSH, el reenvío de puertos, los hosts de salto, comparar un archivo remoto con uno local y una tabla de carga de varios hosts.
Parte V: Seguridad, tiempo y retos
El capítulo de seguridad y auditoría genera contraseñas robustas, verifica sumas de comprobación, encuentra cuentas inactivas con shell de inicio, hace inventario de los archivos SUID y SGID, detecta directorios escribibles por todos sin sticky bit, encuentra secretos en archivos de configuración, audita ajustes de sshd arriesgados, detecta archivos manipulados o con fecha retrasada y señala puertos en escucha inesperados. Fechas, horas y programación de tareas cubre el formato de marcas de tiempo, la conversión de tiempo epoch, los pedidos por semana ISO, recortar una ventana de tiempo de un log, los días entre fechas, la conversión de zonas horarias, añadir una tarea cron con seguridad y ejecutar una tarea una sola vez más tarde. El cuaderno termina con 10 retos del mundo real que lo combinan todo: atacantes presentes en ambos logs, del inventario a hosts y SSH, un informe mensual de ventas, renombrar fotos de forma secuencial, eliminar archivos duplicados con seguridad, la ventana con más errores y su contexto, comparar dos árboles de directorios, un informe de uso de disco con proporciones, enriquecer los datos de empleados con los del departamento y generar un informe de estado en Markdown.
Cómo funciona cada capítulo
Todos los capítulos siguen el mismo esquema:
- Introducción: qué practicas y qué herramientas necesitas;
- Archivos del lab: los archivos que usan los ejercicios, o tu propio sistema en los capítulos de administración;
- Ejercicios: diez tareas, cada una marcada como básica, intermedia o avanzada, para que tanto principiantes como usuarios experimentados encuentren un reto;
- Soluciones: en páginas aparte, para que lo intentes tú primero: el one-liner, su salida real y una explicación completa, a menudo con una Variante y un Error típico;
- Punto de control: las habilidades que ya deberías tener.
Tu solución no tiene por qué coincidir con la del libro. Si produce el mismo resultado de forma segura, es correcta: compara ambas y quédate con las mejores ideas.
Una muestra del nivel de detalle: ¿quién está atacando el servidor SSH?
El ejercicio 14.1 te pide contar los eventos Failed password por dirección IP de origen en logs/auth.log, con el atacante más activo primero. La solución cabe en una línea:
awk '/Failed password/ {print $(NF-3)}' logs/auth.log | sort | uniq -c | sort -rn
La salida clasifica a los cuatro atacantes del lab, encabezados por 45.155.205.233 con 248 intentos fallidos. La explicación muestra por qué esto funciona cuando intentos más simples fallan. Las líneas de contraseña fallida tienen dos formas, … for root from IP port N ssh2 y … for invalid user NAME from IP port N ssh2, así que la IP no está en una posición fija contando desde la izquierda. Sin embargo, siempre es la cuarta empezando por la derecha, y $(NF-3) accede a ella: NF es el número de campos, y los paréntesis hacen que awk evalúe NF-3 como número de campo. Contar desde el final de la línea es una técnica robusta siempre que el principio varíe.
La variante muestra la misma extracción con grep -oP y \K, que descarta todo lo que ha coincidido antes de él. Los ejercicios siguientes del mismo capítulo se apoyan en esto: los nombres de usuario que prueban los atacantes, la ventana de ataque de cada IP con la primera y la última marca de tiempo, un umbral de fallos por hora al estilo de fail2ban y el tiempo de respuesta medio y el percentil 95 por servicio. Este es el nivel de detalle que encontrarás en todo el libro: no solo un comando que funciona, sino el razonamiento que te permite escribir el siguiente por tu cuenta.
Reglas de oro de los one-liners
Además de los ejercicios, el cuaderno te enseña los hábitos que mantienen seguros los one-liners:
- Mira antes de cambiar: ejecuta primero
ls,find … -print,echo mv …osedsin-i; - entrecomilla todo: variables, nombres de archivo y patrones;
- usa separadores nulos para las listas de archivos con
find … -print0 | xargs -0; - construye los pipelines paso a paso y comprueba la salida intermedia con
head; - conoce tu configuración regional:
LC_ALL=Chace que la ordenación sea predecible; - comprueba los códigos de salida con
$?,set -o pipefaily&&; - prefiere lo legible a lo ingenioso.
Por qué este cuaderno es diferente
- Primero, la práctica. 250 ejercicios, no una referencia de comandos: resuelves las tareas antes de leer la respuesta.
- Datos reales, resultados reproducibles. El lab determinista hace que la salida del libro sea exactamente la salida de tu pantalla.
- Cada solución, explicada. Se explica cada opción, patrón y pipe, con variantes y errores típicos que muestran herramientas alternativas y fallos frecuentes.
- Tres niveles de dificultad en cada capítulo. Principiantes y usuarios experimentados encuentran un reto.
- Útil más allá del libro. El análisis de logs, las auditorías de seguridad, el procesamiento de JSON y la comprobación de certificados son tareas que te encontrarás en el trabajo al día siguiente.
- Pensado para exámenes prácticos. Una práctica ideal para exámenes como LFCS y RHCSA.
- En español. Enunciados, explicaciones, variantes y errores típicos en español claro y neutro.
Cómo usar el cuaderno
Sigue los capítulos en orden si buscas soltura general, o salta al área que necesites: procesamiento de texto, análisis de logs, JSON o administración del sistema. Vuelve a crear el lab al principio de cada capítulo, intenta resolver tú mismo cada ejercicio y solo después pasa la página para ver la solución. Si te atascas, la página del manual, --help y las soluciones de los capítulos anteriores son tus mejores aliados. Diez ejercicios por capítulo forman una sesión cómoda, así que, a un capítulo al día, completas el cuaderno en menos de un mes.
Material de referencia que seguirás usando
- Una chuleta de one-liners de 5 páginas agrupada por tareas: archivos y find, uso de disco, permisos y seguridad, archivos comprimidos y copias de seguridad, ver y buscar texto, ordenar, contar y comparar, sed, tr y codificación, awk, análisis de logs, CSV y JSON, tuberías, xargs y bucles, procesos, sistema y systemd, red y SSH, y fechas y programación de tareas;
- un índice de más de 110 comandos, herramientas y construcciones de la shell, cada uno con referencia a los ejercicios donde se usa;
- el script completo del lab, reproducido en el apéndice C;
- un índice con enlaces.
Qué recibes
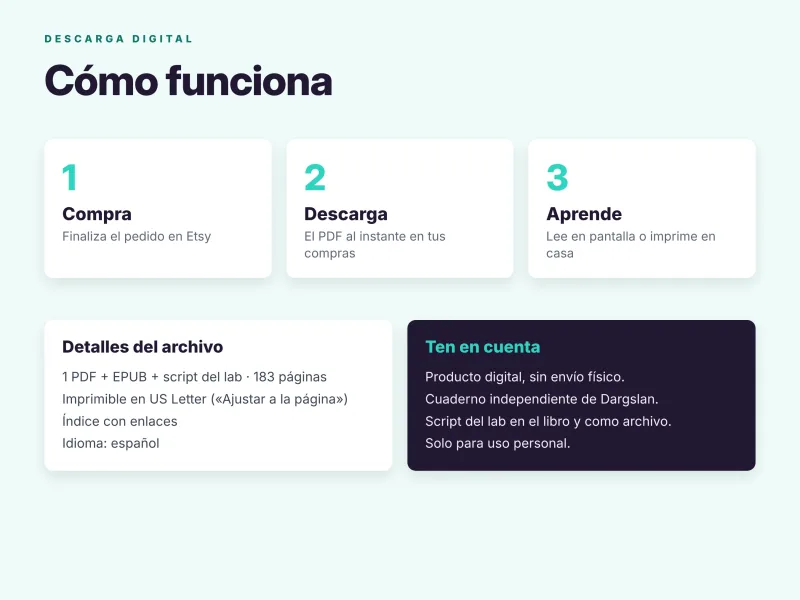
- PDF: 183 páginas, tamaño A4, para imprimir (también se imprime en US Letter con «Ajustar a la página»), con índice con enlaces;
- EPUB: para Kindle, Kobo, Apple Books y otros lectores electrónicos;
- ZIP del lab de prácticas (
Linux-en-una-linea-Lab.zip):setup-lab.sh, listo para ejecutar conbash setup-lab.sh, que crea el lab completo en~/linux-lab; - ZIP con el código fuente (
Linux-en-una-linea-2026-Codigo-fuente.zip): todos los one-liners de las soluciones, ordenados por capítulo; los comandos de cada capítulo se recogen en un archivocommands.shen el orden del libro, y el script del lab se incluye comolab/setup-lab.sh.
Descarga todos los archivos al instante desde tu cuenta de Dargslan después de la compra, o lee el libro directamente en el navegador con el Dargslan Online Reader. No se envía nada por correo postal.
Quién lo ha escrito
Dargslan publica guías prácticas de informática para administradores de Linux, ingenieros DevOps y desarrolladores. Cada título de Dargslan está pensado para usarse delante del teclado: comandos reales, datos reales, ejercicios con soluciones y nada de relleno. En español, Linux en una línea complementa a «Aprender Linux», la «Guía completa de Debian» y la «Guía completa de Cloudflare».
Empieza hoy
Tanto si quieres ir más allá de lo básico, como si preparas un examen práctico o necesitas respuestas más rápidas de los logs y servidores de tu trabajo, este cuaderno convierte el conocimiento de la línea de comandos en una habilidad real. Deja de leer sobre Linux y empieza a usarlo, línea a línea.
Esta es una publicación independiente. Linux es una marca registrada de Linus Torvalds. Las demás marcas pertenecen a sus respectivos propietarios.
Who Is This Book For?
- Usuarios de Linux que conocen lo básico y quieren dominar de verdad la línea de comandos
- Administradores de sistemas e ingenieros DevOps que quieren respuestas más rápidas de logs y servidores
- Desarrolladores que trabajan con Linux a diario
- Estudiantes que preparan exámenes prácticos como LFCS y RHCSA
- Estudiantes de FP (ASIR, SMR) que quieren practicar la terminal con tareas reales
- Cualquiera que aprenda mejor haciendo que leyendo
Who Is This Book NOT For?
- Principiantes absolutos que nunca han abierto una terminal: empieza por nuestra guía «Aprender Linux» y vuelve después
- Quienes buscan una guía para escribir scripts de shell largos: aquí cada solución es una sola línea
- Quienes quieren un libro de texto narrativo: este es un cuaderno de ejercicios con soluciones explicadas
- Usuarios de PowerShell en Windows: el cuaderno usa bash y las herramientas GNU (WSL funciona)
Table of Contents
Cómo usar este cuaderno – p. 4
Parte I · Archivos y navegación (Capítulos 1–5)
Parte II · Procesamiento de texto (Capítulos 6–12)
Parte III · Tratamiento de datos (Capítulos 13–17)
Parte IV · Administración del sistema (Capítulos 18–22)
Parte V · Seguridad, tiempo y retos (Capítulos 23–25)
- Archivos, directorios y globbing – p. 8
- Buscar archivos con find – p. 14
- Uso de disco y limpieza – p. 20
- Usuarios, grupos y permisos – p. 26
- Archivos comprimidos, compresión y copias de seguridad – p. 32
- Ver y recortar texto – p. 39
- Buscar con grep – p. 45
- Ordenar, contar y comparar – p. 51
- Editar texto con sed – p. 57
- Fundamentos de awk – p. 63
- Informes y agregación con awk – p. 68
- tr, codificación y conversión – p. 75
- Análisis de logs de servidores web – p. 82
- Investigación de logs de seguridad y de aplicaciones – p. 88
- CSV y datos tabulares – p. 94
- JSON y YAML con jq y yq – p. 100
- Tuberías, xargs, bucles y trabajos en paralelo – p. 106
- Procesos y recursos – p. 113
- Información del sistema y hardware – p. 119
- Redes y conectividad – p. 126
- Servicios y logs con systemd – p. 132
- Trabajo remoto con SSH y rsync – p. 139
- Seguridad y auditoría – p. 147
- Fechas, horas y programación de tareas – p. 154
- Retos del mundo real – p. 161
Apéndices
Apéndice A: Chuleta de one-liners – p. 169
Apéndice B: Índice de comandos – p. 174
Apéndice C: El script del lab – p. 178
Requirements
- Conocimientos básicos de Linux: abrir una terminal, moverte entre directorios y ejecutar comandos
- Cualquier sistema Linux actual con bash y las herramientas GNU: una máquina física, una máquina virtual, WSL o un contenedor
- Probado en Debian 13, Ubuntu 26.04 LTS y la familia RHEL 10 (AlmaLinux, Rocky Linux)
- Algunos paquetes adicionales para ciertos capítulos, como gawk, jq, yq, datamash, parallel y sqlite3 (se indican los comandos de instalación)
- Acceso con sudo para los capítulos de administración del sistema