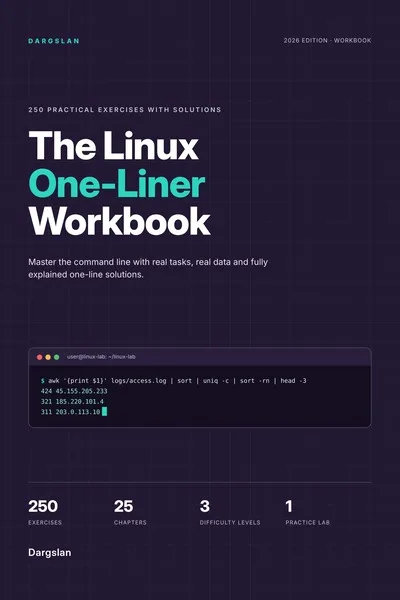
Linux en une ligne
Cahier d’exercices : 250 exercices pratiques avec solutions expliquées
What's Included:
At a Glance
Linux en une ligne is a professional Linux Fundamentals eBook by Dargslan, 187 pages, available as an instant PDF and EPUB download for €13.90, DRM-free and yours to keep, with free updates. Cahier d’exercices : 250 exercices pratiques avec solutions expliquées.
- Length: 187 pages
- Format: PDF and EPUB (instant download)
- Language: fr
- Topic: Linux Fundamentals
- Edition: 1st Edition
- Price: €13.90
Key Highlights
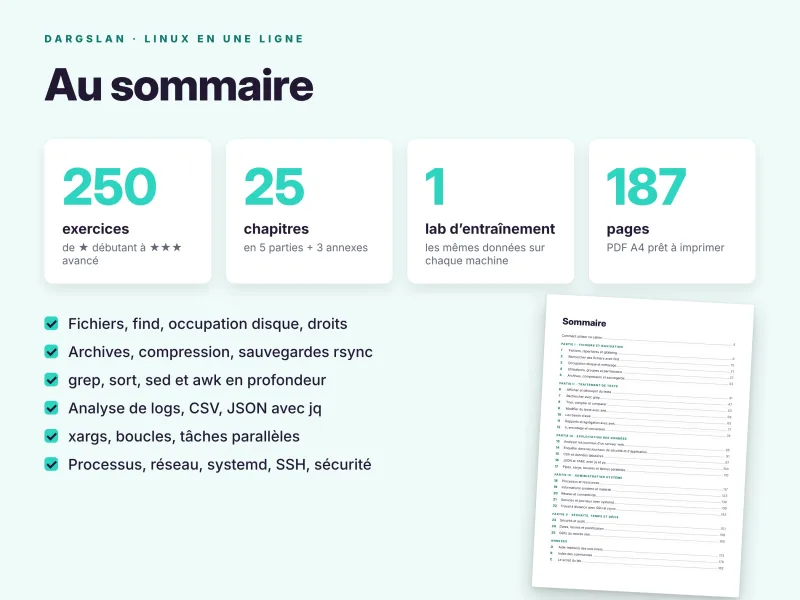
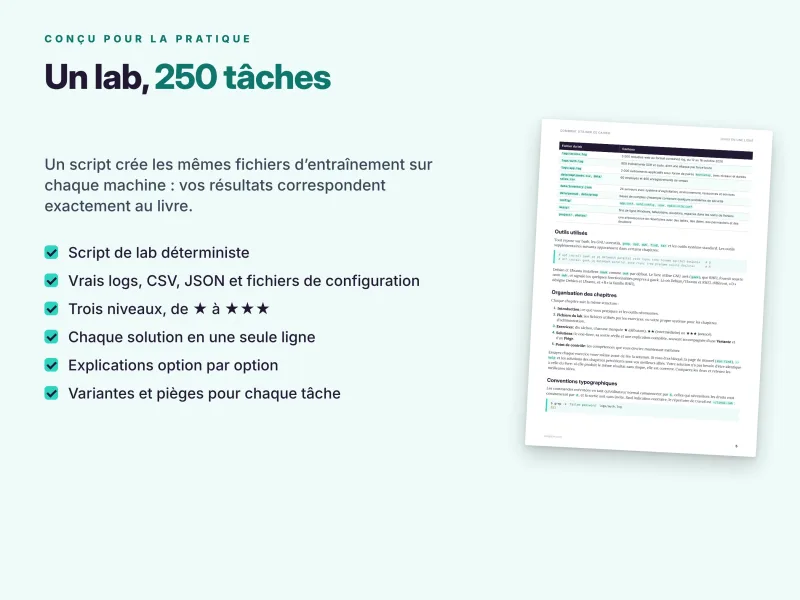
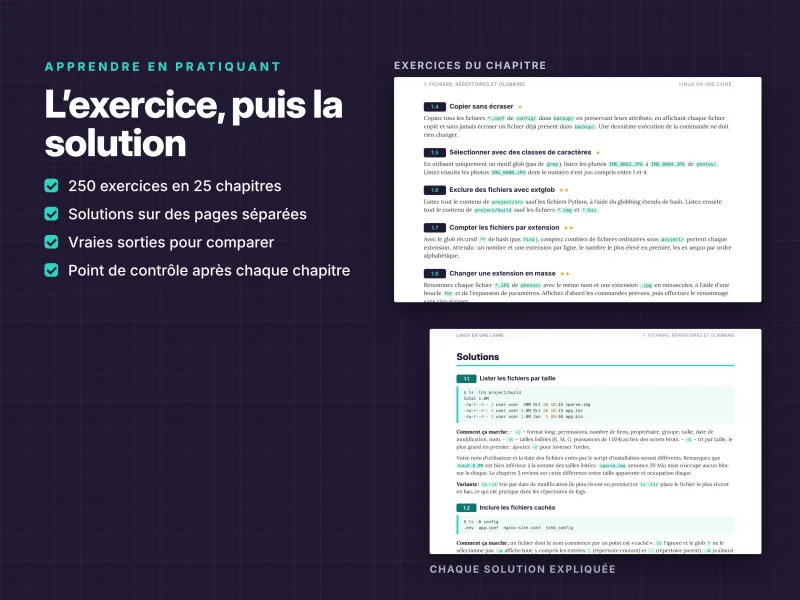
- 187 pages, 250 exercices en 25 chapitres et 5 parties, consignes et explications en français
- Chaque solution tient sur une seule ligne de commande, avec sa sortie réelle
- Des explications option par option, avec variantes et pièges
- Trois niveaux de difficulté dans chaque chapitre : débutant, intermédiaire et avancé
- Solutions sur des pages séparées, pour essayer d'abord
- Script de lab avec journaux web, SSH et applicatifs, CSV, JSON et fichiers de configuration
- Données de lab déterministes : votre sortie correspond exactement au livre
- grep, sed, awk, find, xargs, jq, yq, datamash, rsync, systemd et bien d'autres
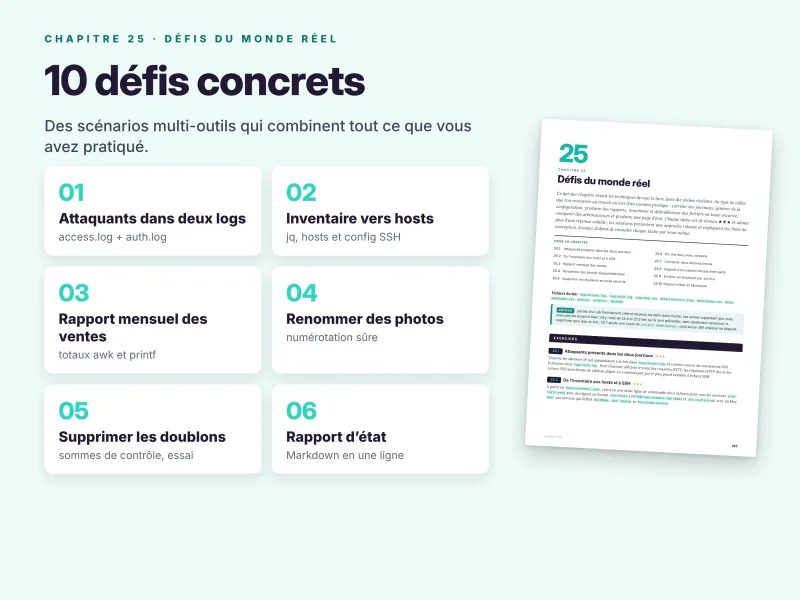
- 10 défis du monde réel qui combinent tout
- Testé sous Debian 13, Ubuntu 26.04 LTS et la famille RHEL 10
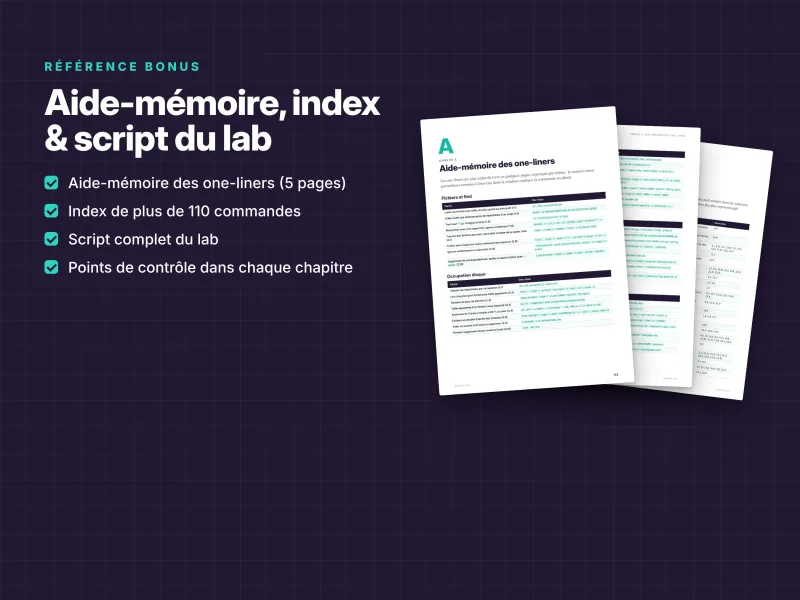
- Aide-mémoire de 5 pages et index de plus de 110 commandes
- PDF + EPUB + script du lab + toutes les solutions en ZIP
Overview
Maîtrisez la ligne de commande Linux en pratiquant, en français : 250 exercices, chacun résolu par une seule ligne de commande expliquée option par option, sur un lab de vrais logs, CSV, JSON et fichiers de configuration. 187 pages. PDF + EPUB + lab + ZIP.
The Problem
Beaucoup d'utilisateurs de Linux connaissent le nom des outils classiques (grep, sed, awk, find, xargs), mais copient encore des commandes trouvées sur Internet dès qu'une vraie question se pose. Les tutoriels expliquent les options une à une, sur des exemples jouets, et montrent rarement comment combiner les outils en un pipeline qui répond à une question utile : qui attaque le serveur, quel service tombe en panne, quels fichiers sont des doublons.
Sans données réalistes pour s'entraîner et sans explication de la raison pour laquelle une commande fonctionne, les connaissances ne se transforment jamais en aisance, et chaque nouvelle tâche repart de zéro.
The Solution
Linux en une ligne construit l'aisance par la pratique : 250 exercices en 25 chapitres, chacun résolu par une seule ligne de commande et expliqué option par option, avec la sortie réelle, des variantes et des pièges, et toutes les explications en français.
Un script crée un lab d'entraînement déterministe avec des journaux de serveur web, de SSH et d'application, des données CSV et JSON, des fichiers de configuration et des arborescences en désordre : vos résultats correspondent exactement au livre. Vous progressez des fichiers et de find à grep, sed et awk, puis à l'analyse de journaux, jq et yq, xargs et les tâches parallèles, l'administration système, les audits de sécurité et dix défis du monde réel. Un aide-mémoire de 5 pages et un index de plus de 110 commandes le rendent utile longtemps après la dernière page.
About This Book
Linux en une ligne : cahier d'exercices : 250 exercices pratiques avec solutions expliquées
Lire des choses sur la ligne de commande, ce n'est pas la même chose que s'en servir. Vous pouvez savoir ce que font grep, awk, sed et find et rester bloqué devant une vraie question : quelles adresses IP ont martelé le serveur SSH la nuit dernière, quel service produit le plus d'erreurs, quels fichiers de cette arborescence sont des doublons, quel certificat expire en premier. L'aisance vient de la pratique : résoudre de vraies tâches, sur de vraies données, jusqu'à ce qu'assembler de petits outils avec des pipes devienne un réflexe. Linux en une ligne vous offre exactement cette pratique, entièrement en français.
Ce cahier d'exercices de 187 pages contient 250 exercices pratiques, et chaque solution est un one-liner : une commande complète écrite sur une seule ligne, le plus souvent un pipeline, que vous pouvez taper, exécuter, modifier et réutiliser. Après chaque série d'exercices viennent les solutions, avec leur sortie réelle et une explication précise de chaque option, de chaque motif et de chaque pipe, souvent accompagnées d'une variante et d'un piège classique. Vous apprenez les commandes, et vous apprenez aussi à raisonner en petits outils reliés par des pipes.
Un lab d'entraînement identique au livre
La plupart des exercices portent sur le même ensemble de fichiers réalistes, créés par un seul script, setup-lab.sh, fourni en téléchargement séparé et reproduit intégralement dans l'annexe C. Une seule commande construit le lab dans ~/linux-lab :
logs/access.log: 3 000 requêtes web au format combined log ;logs/auth.log: 800 événements SSH et sudo, dont une attaque par force brute ;logs/app.log: 2 000 événements applicatifs sous forme de paireskey=value, avec niveaux et durées ;data/employees.csvetdata/sales.csv: 60 employés et 400 enregistrements de ventes ;data/inventory.json: 24 serveurs avec système d'exploitation, environnement, ressources et services ;- des fichiers
passwdetgroupd'exemple contenant quelques problèmes de sécurité, des fichiers de configuration commesshd_config,.envet un site nginx, un dossiermessy/avec fins de ligne Windows, tabulations, doublons et espaces dans les noms de fichiers, ainsi que des arborescences de projet et de photos avec des tailles, des dates, des permissions et des doublons.
Les données sont générées de manière déterministe : chaque lecteur obtient des fichiers identiques octet pour octet, et votre sortie correspond à celle imprimée dans le livre. Recréer le lab prend une seconde ; vous pouvez donc repartir d'un lab tout neuf à chaque chapitre, même après une modification avec sed -i ou un nettoyage avec find -delete. Comme dans la pratique, les commandes, les sorties des programmes et les données d'exercice restent en anglais ; toutes les consignes et explications sont en français.
Testé sur des Linux récents, utilisable presque partout
Tout repose sur bash, les GNU coreutils, grep, sed, awk, find, tar et les outils système standard. Le cahier a été testé sous Debian 13, Ubuntu 26.04 LTS et la famille RHEL 10 (AlmaLinux, Rocky Linux), et il fonctionne sur tout système Linux récent, dans une machine virtuelle, sous WSL ou dans un conteneur. Quelques chapitres utilisent des outils supplémentaires (gawk, jq, yq, datamash, GNU parallel, zstd, rsync, sqlite3, dos2unix et d'autres), dont les commandes d'installation sont données pour apt et pour dnf. Debian et Ubuntu installant mawk comme awk par défaut, le livre explique la différence et signale les quelques fonctionnalités propres à GNU awk.
Partie I – Fichiers et navigation
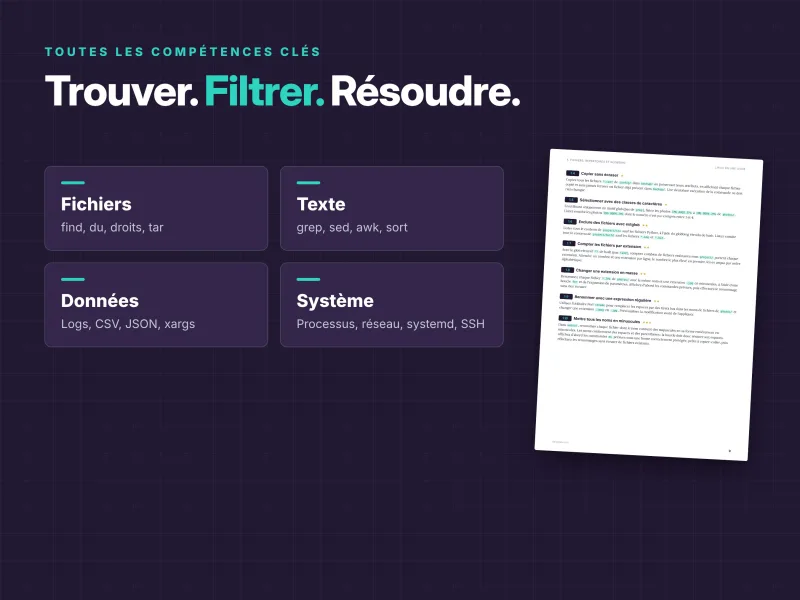
Vous commencez là où tout administrateur passe ses journées : le système de fichiers. Vous travaillez avec les fichiers, les répertoires et le globbing, le renommage en masse et les noms avec espaces qui cassent tant de scripts. Le chapitre find couvre les noms, les tailles, les dates, les permissions, les expressions régulières, l'exclusion de répertoires entiers, -exec et la suppression sûre des fichiers de sauvegarde. Vous mesurez l'occupation disque, traquez les plus gros fichiers, les fichiers creux et les doublons, et faites le ménage. Vous examinez utilisateurs, groupes et permissions, puis créez des archives avec compression, sommes de contrôle et instantanés rsync.
Partie II – Traitement de texte
C'est le cœur de la ligne de commande. Vous affichez et découpez du texte avec head, tail, cut et sed -n, recherchez avec grep et ripgrep à l'aide d'expressions régulières, puis triez, comptez, comparez et joignez des fichiers. Le chapitre sed modifie des fichiers de configuration en toute sécurité : remplacer une chaîne partout, supprimer des plages, retirer commentaires et lignes vides, réordonner avec des groupes, corriger sur place les fins de ligne CRLF avec une sauvegarde, décommenter une directive et modifier une valeur dans une seule section. Deux chapitres sur awk vous mènent des champs et des motifs aux rapports, aux agrégations par groupe et aux jointures. Un chapitre consacré à tr, l'encodage et la conversion traite des fins de ligne, de Base64, de l'hexadécimal et du formatage des nombres.
Partie III – Exploitation des données
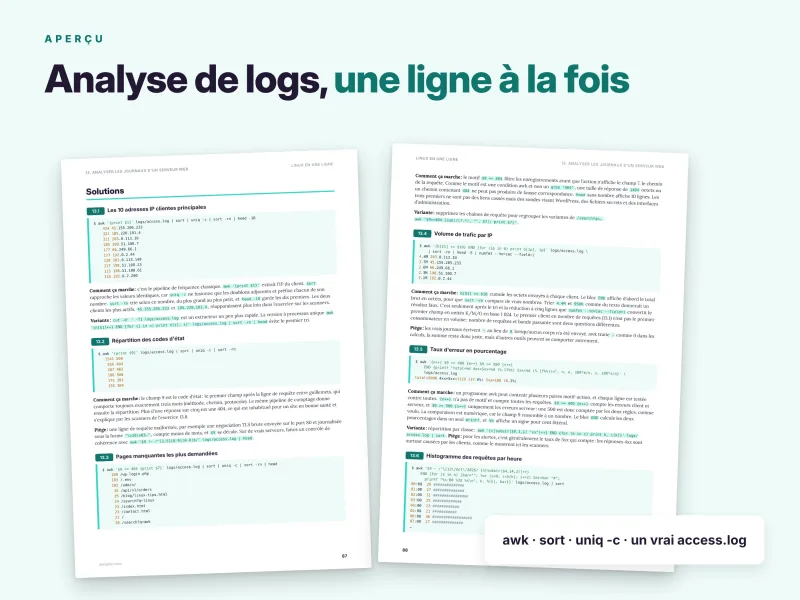
Vous répondez maintenant à de vraies questions à partir de vraies données. Vous analysez les journaux d'un serveur web : top des IP clientes, répartition des codes d'état, pages manquantes les plus demandées, trafic par IP, taux d'erreur, histogramme des requêtes par heure, robots contre humains, scanners de vulnérabilités, minute la plus chargée et visiteurs uniques par jour. Vous enquêtez dans les journaux de sécurité et d'application : attaquants par force brute, noms d'utilisateur essayés, usage de sudo, erreurs par service, requêtes les plus lentes et temps de réponse en percentiles. Vous traitez des CSV et des données tabulaires avec awk, datamash et SQLite en une ligne, interrogez et transformez du JSON et du YAML avec jq et yq (y compris générer des lignes /etc/hosts et convertir du JSON en YAML), et maîtrisez pipes, xargs, boucles et tâches parallèles : noms avec espaces, entrée vide, tee, tableaux, détection des échecs dans un pipeline et compression de fichiers en parallèle.
Partie IV – Administration système
Ces chapitres s'exécutent sur votre propre machine : leur sortie est donc signalée comme exemple de sortie, variable selon le système. Dans processus et ressources, vous trouvez les plus gros consommateurs de mémoire et de CPU, comptez les processus par utilisateur, affichez une arborescence de processus, arrêtez des processus par leur nom en toute sécurité, libérez un port occupé, limitez durée d'exécution et priorité, comparez la charge au nombre de cœurs, examinez un processus dans /proc et trouvez les zombies et leurs parents. Informations système et matériel couvre un résumé du système et du noyau, le CPU et la mémoire, l'uptime et l'heure de démarrage, les disques et partitions, la nécessité d'un redémarrage, les périphériques PCI et USB, la détection de la virtualisation et les plus gros paquets installés.
Vous vérifiez le réseau et la connectivité : interfaces, passerelle par défaut, DNS direct et inverse, IP publique, ports en écoute avec leurs processus, connexions par IP distante, test d'un port TCP, code d'état et temps de réponse HTTP, débit de téléchargement et expiration des certificats TLS. Avec systemd et le journal, vous listez les unités en échec et les services activés, lisez les journaux depuis une heure donnée, trouvez les erreurs du démarrage actuel et du précédent, affichez les timers et leur prochaine exécution, réduisez l'espace disque du journal, repérez les unités les plus bavardes et les services qui ont redémarré. Travail à distance avec SSH et rsync couvre les empreintes de clés, les entrées known_hosts, l'installation de votre clé publique, l'exécution d'une commande sur de nombreux hôtes, la synchronisation miroir avec rsync, tar en flux via SSH, la redirection de ports, les hôtes de rebond, la comparaison d'un fichier distant et d'un fichier local et un tableau de charge sur plusieurs hôtes.
Partie V – Sécurité, temps et défis
Le chapitre sécurité et audit génère des mots de passe robustes, vérifie des sommes de contrôle, trouve les comptes dormants dotés d'un shell de connexion, inventorie les fichiers SUID et SGID, repère les répertoires modifiables par tous sans sticky bit, débusque les secrets dans les fichiers de configuration, audite les réglages sshd risqués, détecte les fichiers altérés ou antidatés et signale les ports en écoute inattendus. Dates, heures et planification couvre le formatage des horodatages, la conversion depuis l'epoch, les commandes par semaine ISO, l'extraction d'une fenêtre horaire dans un journal, le nombre de jours entre deux dates, la conversion de fuseaux horaires, l'ajout sûr d'une tâche cron et l'exécution différée d'une tâche. Le cahier se termine par 10 défis du monde réel qui combinent tout : attaquants présents dans les deux journaux, de l'inventaire aux hosts et à SSH, rapport mensuel des ventes, renommage séquentiel de photos, suppression sûre des doublons, pic d'erreurs avec contexte, comparaison de deux arborescences, rapport d'occupation disque avec parts, enrichissement des employés par service et rapport d'état en Markdown.
Comment fonctionne chaque chapitre
Chaque chapitre suit la même structure :
- Introduction : ce que vous pratiquez et les outils nécessaires ;
- Fichiers du lab : les fichiers utilisés par les exercices, ou votre propre système pour les chapitres d'administration ;
- Exercices : dix tâches, chacune marquée débutant, intermédiaire ou avancé, pour que débutants comme utilisateurs expérimentés trouvent un défi à leur mesure ;
- Solutions : sur des pages séparées, pour que vous essayiez d'abord ; le one-liner, sa sortie réelle et une explication complète, souvent avec une Variante et un Piège ;
- Point de contrôle : les compétences que vous devriez maintenant maîtriser.
Votre solution n'a pas besoin d'être identique à celle du livre : si elle produit le même résultat sans risque, elle est correcte. Comparez les deux et retenez les meilleures idées.
Un aperçu du niveau de détail : qui attaque le serveur SSH ?
L'exercice 14.1 vous demande de compter les événements Failed password par IP source dans logs/auth.log, l'attaquant le plus actif en premier. La solution tient en une ligne :
awk '/Failed password/ {print $(NF-3)}' logs/auth.log | sort | uniq -c | sort -rn
La sortie classe les quatre attaquants du lab, avec en tête 45.155.205.233 et ses 248 échecs. L'explication montre pourquoi cette commande fonctionne là où des tentatives plus simples échouent. Les lignes d'échec se présentent sous deux formes, … for root from IP port N ssh2 et … for invalid user NAME from IP port N ssh2 : l'adresse IP n'est donc pas à une position fixe en partant de la gauche. Elle est en revanche toujours la quatrième en partant de la droite, et $(NF-3) la désigne : NF est le nombre de champs, et les parenthèses font évaluer NF-3 par awk comme un numéro de champ. Compter à partir de la fin de la ligne est une technique robuste chaque fois que le début varie.
La variante obtient la même extraction avec grep -oP et \K, qui écarte tout ce qui a correspondu avant lui. Les exercices suivants du chapitre s'appuient sur cette base : les noms d'utilisateur essayés par les attaquants, la fenêtre d'attaque par IP avec premier et dernier horodatage, un contrôle de seuil façon fail2ban par heure, et la durée moyenne et le 95e percentile par service. C'est le niveau de détail que vous trouverez tout au long du cahier : pas seulement une commande qui fonctionne, mais le raisonnement qui vous permet d'écrire la suivante vous-même.
Les règles d'or des one-liners
En parallèle des exercices, le cahier vous transmet les habitudes qui rendent les one-liners sûrs :
- regardez avant de modifier : lancez d'abord
ls,find … -print,echo mv …ousedsans-i; - mettez tout entre guillemets : variables, noms de fichiers et motifs ;
- utilisez des séparateurs nuls pour les listes de fichiers, avec
find … -print0 | xargs -0; - construisez vos pipelines pas à pas et vérifiez la sortie intermédiaire avec
head; - connaissez votre locale :
LC_ALL=Crend le tri prévisible ; - vérifiez les codes de retour avec
$?,set -o pipefailet&&; - préférez la lisibilité à l'astuce.
Pourquoi ce cahier est différent
- La pratique d'abord. 250 exercices, pas une référence de commandes : vous résolvez la tâche avant de lire la réponse.
- De vraies données, des résultats reproductibles. Grâce au lab déterministe, la sortie du livre est exactement celle de votre écran.
- Chaque solution expliquée. Chaque option, chaque motif et chaque pipe sont expliqués, avec des variantes et des pièges qui présentent d'autres outils et les erreurs courantes.
- Trois niveaux de difficulté dans chaque chapitre. Débutants comme utilisateurs expérimentés y trouvent un défi.
- Utile bien au-delà du livre. Analyse de journaux, audits de sécurité, traitement de JSON et vérification de certificats : vous retrouverez ces tâches au travail dès le lendemain.
- Idéal pour les examens. Un entraînement pratique parfait pour des examens comme le LFCS et le RHCSA.
Comment utiliser le cahier
Suivez les chapitres dans l'ordre si vous voulez une aisance générale, ou allez directement au domaine qui vous intéresse : traitement de texte, analyse de journaux, JSON ou administration système. Recréez le lab au début de chaque chapitre, essayez chaque exercice vous-même, et ne tournez la page vers la solution qu'ensuite. Si vous êtes bloqué, la page de manuel, --help et les solutions des chapitres précédents sont vos meilleurs alliés. Dix exercices par chapitre font une séance confortable : à raison d'un chapitre par jour, vous terminez le cahier en moins d'un mois.
Des références que vous garderez sous la main
- Un aide-mémoire des one-liners de 5 pages classé par tâche : fichiers et find, occupation disque, permissions et sécurité, archives et sauvegarde, afficher et rechercher du texte, trier, compter et comparer, sed, tr et encodage, awk, analyse de journaux, CSV et JSON, pipes, xargs et boucles, processus, système et systemd, réseau et SSH, dates et planification ;
- un index de plus de 110 commandes, outils et constructions du shell, chacun relié aux exercices qui le mettent en œuvre ;
- le script complet du lab, reproduit dans l'annexe C ;
- un sommaire cliquable.
Ce que vous recevez
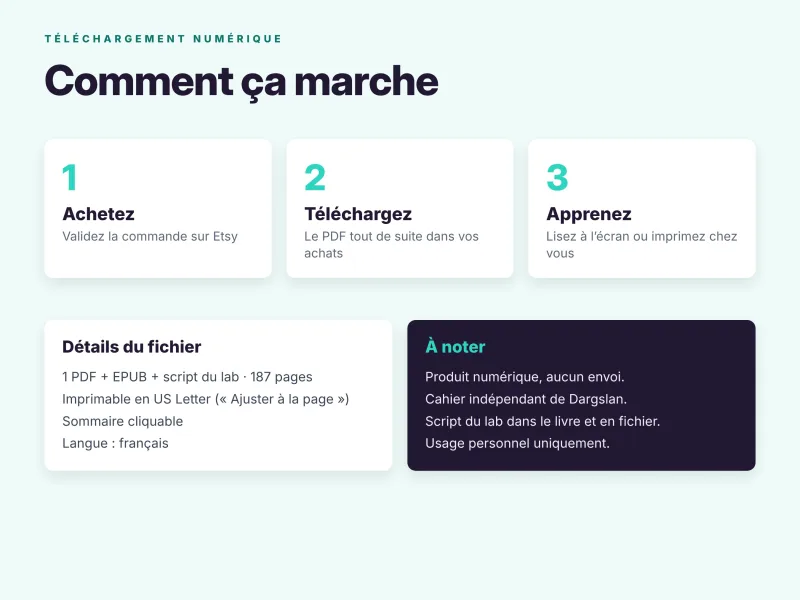
- PDF : 187 pages, format A4, imprimable (également sur US Letter avec « Ajuster à la page »), avec un sommaire cliquable ;
- EPUB : pour Kindle, Kobo, Apple Books et les autres liseuses ;
- ZIP du lab d'entraînement :
setup-lab.sh, prêt à lancer avecbash setup-lab.sh, qui crée le lab complet dans~/linux-lab; - ZIP du code source (
Linux-en-une-ligne-2026-Code-source.zip) : tous les one-liners des solutions, classés par chapitre ; les commandes de chaque chapitre sont rassemblées dans un fichiercommands.sh, dans l'ordre du livre, et le script du lab est inclus souslab/setup-lab.sh.
Après l'achat, vous téléchargez immédiatement tous les fichiers depuis votre compte Dargslan, ou vous lisez le livre directement dans votre navigateur avec le Dargslan Online Reader. Aucun envoi physique.
L'éditeur
Dargslan publie des guides informatiques pratiques pour les administrateurs Linux, les ingénieurs DevOps et les développeurs. Chaque titre Dargslan est conçu pour être utilisé au clavier : de vraies commandes, de vraies données, des exercices corrigés et aucun remplissage. En français, Linux en une ligne complète « Apprendre Linux », « Le guide complet de Debian » et « Le guide complet de Cloudflare ».
Commencez dès aujourd'hui
Que vous vouliez dépasser les bases, préparer un examen pratique ou obtenir plus vite des réponses de vos journaux et de vos serveurs au travail, ce cahier transforme vos connaissances de la ligne de commande en véritable compétence. Arrêtez de lire sur Linux : pratiquez-le, une ligne à la fois.
Ce cahier d'exercices est une publication indépendante. Linux est une marque déposée de Linus Torvalds. Toutes les autres marques appartiennent à leurs propriétaires respectifs.
Who Is This Book For?
- Les utilisateurs de Linux qui connaissent les bases et veulent une vraie aisance en ligne de commande
- Les administrateurs systèmes et ingénieurs DevOps qui veulent obtenir plus vite des réponses de leurs journaux et de leurs serveurs
- Les développeurs qui travaillent sous Linux tous les jours
- Les candidats aux examens pratiques comme le LFCS et le RHCSA
- Toute personne qui apprend mieux en faisant qu'en lisant
Who Is This Book NOT For?
- Les grands débutants qui n'ont jamais ouvert de terminal : commencez par « Apprendre Linux », puis revenez à ce cahier
- Les lecteurs qui cherchent un guide pour écrire des scripts shell longs : ce cahier se concentre sur les commandes en une ligne
- Les lecteurs qui veulent un manuel narratif : ceci est un cahier d'exercices avec solutions expliquées ; pour une présentation complète d'une distribution, voyez « Le guide complet de Debian »
- Les utilisateurs de Windows PowerShell : le cahier utilise bash et les outils GNU (WSL convient)
Table of Contents
Comment utiliser ce cahier – p. 4
Partie I · Fichiers et navigation (Chapitres 1–5)
Partie II · Traitement de texte (Chapitres 6–12)
Partie III · Exploitation des données (Chapitres 13–17)
Partie IV · Administration système (Chapitres 18–22)
Partie V · Sécurité, temps et défis (Chapitres 23–25)
- Fichiers, répertoires et globbing – p. 8
- Rechercher des fichiers avec find – p. 15
- Occupation disque et nettoyage – p. 21
- Utilisateurs, groupes et permissions – p. 27
- Archives, compression et sauvegarde – p. 33
- Afficher et découper du texte – p. 41
- Rechercher avec grep – p. 47
- Trier, compter et comparer – p. 53
- Modifier du texte avec sed – p. 59
- Les bases d'awk – p. 65
- Rapports et agrégation avec awk – p. 71
- tr, encodage et conversion – p. 78
- Analyser les journaux d'un serveur web – p. 85
- Enquêter dans les journaux de sécurité et d'application – p. 91
- CSV et données tabulaires – p. 97
- JSON et YAML avec jq et yq – p. 104
- Pipes, xargs, boucles et tâches parallèles – p. 110
- Processus et ressources – p. 117
- Informations système et matériel – p. 123
- Réseau et connectivité – p. 130
- Services et journaux avec systemd – p. 136
- Travail à distance avec SSH et rsync – p. 143
- Sécurité et audit – p. 151
- Dates, heures et planification – p. 158
- Défis du monde réel – p. 165
Annexes
Annexe A : Aide-mémoire des one-liners – p. 173
Annexe B : Index des commandes – p. 178
Annexe C : Le script du lab – p. 182
Requirements
- Des connaissances de base de Linux : ouvrir un terminal, se déplacer entre les répertoires, lancer des commandes
- Tout système Linux récent avec bash et les outils GNU : machine physique, machine virtuelle, WSL ou conteneur
- Testé sous Debian 13, Ubuntu 26.04 LTS et la famille RHEL 10 (AlmaLinux, Rocky Linux)
- Quelques paquets supplémentaires pour certains chapitres, comme gawk, jq, yq, datamash, parallel et sqlite3 (les commandes d'installation sont fournies)
- Un accès sudo pour les chapitres d'administration système