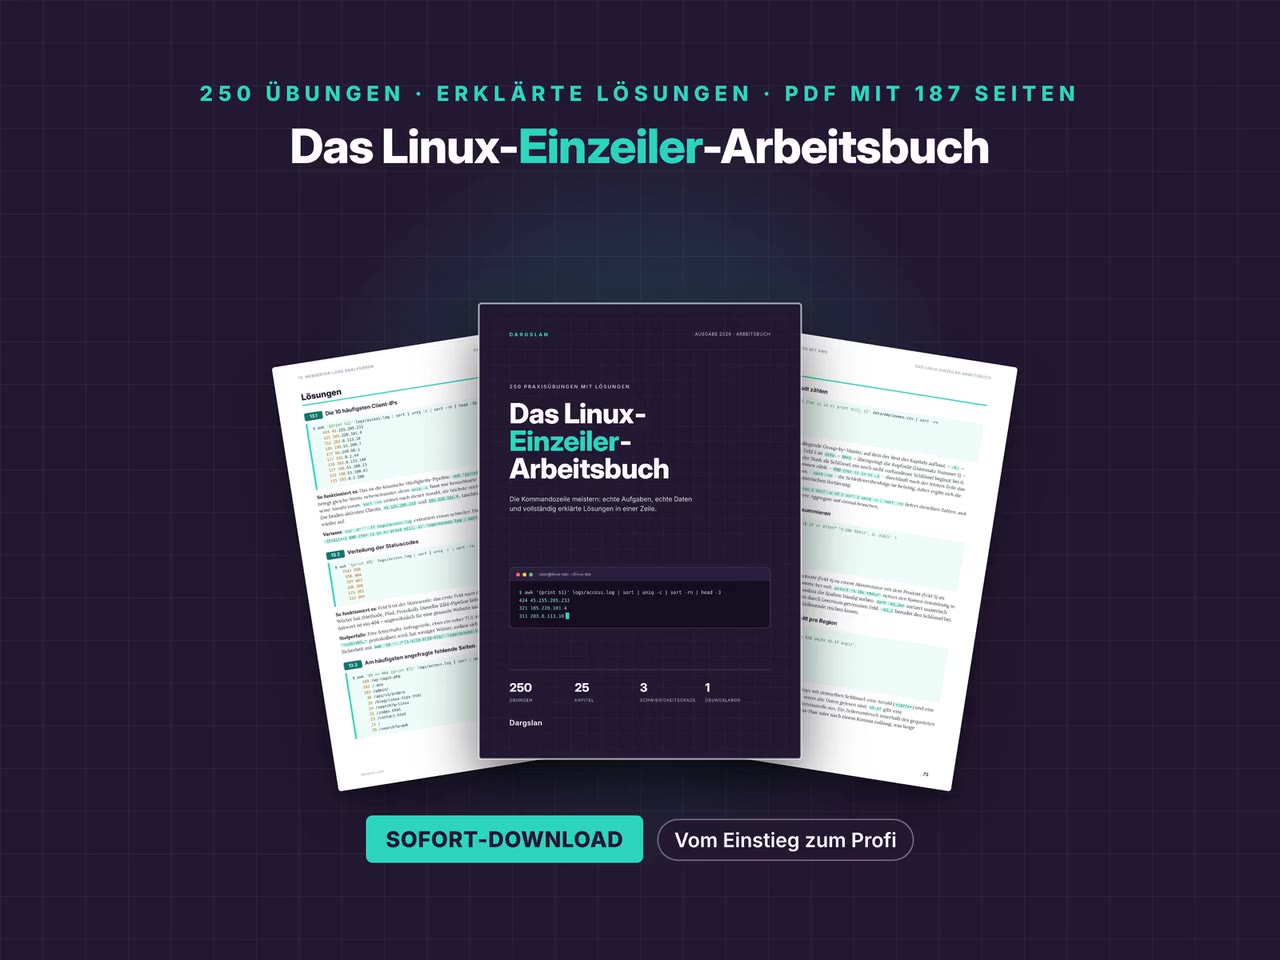
Das Linux-Einzeiler-Arbeitsbuch
250 Praxisübungen mit erklärten Lösungen
What's Included:
At a Glance
Das Linux-Einzeiler-Arbeitsbuch is a professional Linux Fundamentals eBook by Dargslan, 187 pages, available as an instant PDF and EPUB download for €13.85, DRM-free and yours to keep, with free updates. 250 Praxisübungen mit erklärten Lösungen.
- Length: 187 pages
- Format: PDF and EPUB (instant download)
- Language: de
- Topic: Linux Fundamentals
- Edition: 1st Edition
- Price: €13.85
Key Highlights
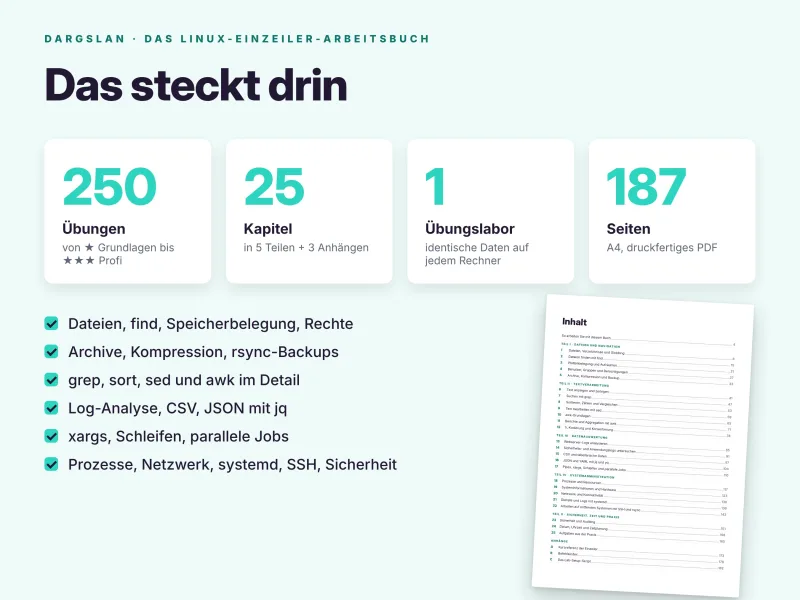
- 187 Seiten, 250 Übungen in 25 Kapiteln und 5 Teilen – komplett auf Deutsch
- Jede Lösung eine einzige Befehlszeile, mit echter Ausgabe
- Erklärungen Option für Option, dazu Varianten und Stolperfallen
- Drei Schwierigkeitsgrade in jedem Kapitel: Grundlagen, Fortgeschritten und Profi
- Lösungen auf eigenen Seiten – erst selbst probieren
- Skript für das Übungslabor mit Web-, SSH- und Anwendungslogs, CSV-, JSON- und Konfigurationsdateien
- Deterministische Labordaten: Ihre Ausgabe stimmt exakt mit dem Buch überein
- grep, sed, awk, find, xargs, jq, yq, datamash, rsync, systemd und mehr
- 10 Praxisaufgaben, die alles verbinden
- Getestet unter Debian 13, Ubuntu 26.04 LTS und der RHEL-10-Familie
- 5-seitige Kurzreferenz und ein Index mit über 110 Befehlen
- PDF + EPUB + Lab-Skript + alle Lösungen als ZIP
Overview
Die Linux-Kommandozeile durch Üben meistern, komplett auf Deutsch: 250 Praxisübungen, jede mit einer einzigen Befehlszeile gelöst und Option für Option erklärt, an echten Logs, CSV-, JSON- und Konfigurationsdateien. 187 Seiten. PDF + EPUB + Lab-Skript + Code-ZIP.
The Problem
Viele Linux-Anwender kennen die Namen der klassischen Werkzeuge – grep, sed, awk, find, xargs –, kopieren aber trotzdem Befehle aus Suchergebnissen, sobald eine echte Frage auftaucht. Anleitungen erklären Optionen isoliert an Spielzeugbeispielen und zeigen selten, wie man Werkzeuge zu einer Pipeline kombiniert, die etwas Nützliches beantwortet: Wer greift den Server an? Welcher Dienst fällt aus? Welche Dateien sind Duplikate?
Ohne realistische Übungsdaten und ohne Erklärungen, warum ein Befehl funktioniert, wird aus dem Wissen nie Routine – und jede neue Aufgabe beginnt wieder bei null.
The Solution
Das Linux-Einzeiler-Arbeitsbuch baut Routine durch Übung auf, komplett auf Deutsch: 250 Übungen in 25 Kapiteln, jede mit einer einzigen Befehlszeile gelöst und Option für Option erklärt, mit echter Ausgabe, Varianten und Stolperfallen.
Ein Setup-Skript erzeugt ein deterministisches Übungslabor mit Webserver-, SSH- und Anwendungslogs, CSV- und JSON-Daten, Konfigurationsdateien und unordentlichen Verzeichnisbäumen, sodass Ihre Ergebnisse exakt mit dem Buch übereinstimmen. Sie arbeiten sich von Dateien und find über grep, sed und awk bis zu Log-Analyse, jq und yq, xargs und parallelen Jobs, Systemadministration, Sicherheitsprüfungen und zehn Praxisaufgaben vor. Eine 5-seitige Kurzreferenz und ein Index mit über 110 Befehlen machen das Buch auch danach zum Nachschlagewerk.
About This Book
Das Linux-Einzeiler-Arbeitsbuch: 250 Praxisübungen mit erklärten Lösungen
Über die Kommandozeile zu lesen ist etwas anderes, als sie zu benutzen. Sie können wissen, was grep, awk, sed und find tun, und trotzdem erstarren, sobald eine echte Frage auftaucht: Welche IP-Adressen haben letzte Nacht den SSH-Server bombardiert? Welcher Dienst wirft die meisten Fehler? Welche Dateien in diesem Verzeichnisbaum sind Duplikate? Welches Zertifikat läuft als Nächstes ab? Routine entsteht durch Übung – durch das Lösen echter Aufgaben an echten Daten, bis das Verbinden kleiner Werkzeuge über Pipes zur zweiten Natur wird. Das Linux-Einzeiler-Arbeitsbuch gibt Ihnen genau diese Übung.
Dieses 187-seitige Arbeitsbuch enthält 250 Praxisübungen, komplett auf Deutsch, und jede Lösung ist ein Einzeiler: eine einzige Befehlszeile, meist eine Pipeline, die Sie eintippen, ausführen, abwandeln und wiederverwenden können. Nach jedem Übungsblock folgen die Lösungen mit ihrer echten Ausgabe und einer genauen Erklärung jeder Option, jedes Musters und jeder Pipe, oft ergänzt um eine Variante und eine typische Stolperfalle. Sie lernen die Befehle – und Sie lernen, in kleinen Werkzeugen zu denken, die über Pipes verbunden werden.
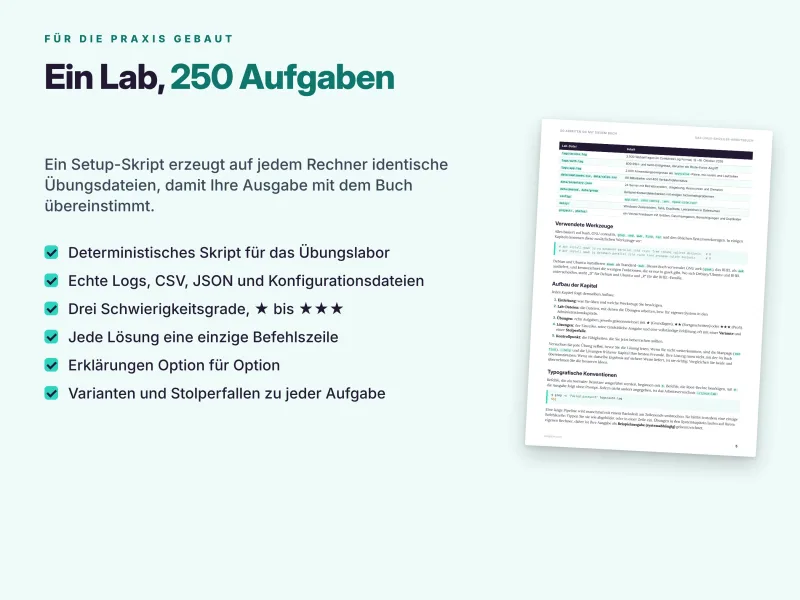
Ein Übungslabor, das exakt zum Buch passt
Die meisten Übungen arbeiten mit denselben realistischen Dateien, die ein einziges Skript erzeugt: setup-lab.sh. Es liegt als separater Download bei und ist außerdem vollständig in Anhang C abgedruckt. Ein Befehl baut das Labor in ~/linux-lab auf:
logs/access.log– 3.000 Webanfragen im Combined Log Format;logs/auth.log– 800 SSH- und sudo-Ereignisse, darunter ein Brute-Force-Angriff;logs/app.log– 2.000 Anwendungsereignisse alskey=value-Paare mit Leveln und Laufzeiten;data/employees.csvunddata/sales.csv– 60 Mitarbeiter und 400 Verkaufsdatensätze;data/inventory.json– 24 Server mit Betriebssystem, Umgebung, Ressourcen und Diensten;- Beispieldateien
passwdundgroupmit einigen Sicherheitsproblemen, Konfigurationsdateien wiesshd_config,.envund eine Nginx-Site, ein Ordnermessy/mit Windows-Zeilenenden, Tabs, Duplikaten und Leerzeichen in Dateinamen sowie Projekt- und Fotoverzeichnisse mit Größen, Datumsangaben, Berechtigungen und Duplikaten.
Die Daten werden deterministisch erzeugt: Jeder Leser erhält byteweise identische Dateien, und Ihre Ausgabe stimmt mit der im Buch abgedruckten überein. Das Labor neu anzulegen dauert eine Sekunde, sodass Sie jedes Kapitel mit einem frischen Stand beginnen können – auch nach einer Bearbeitung mit sed -i oder einem Aufräumen mit find -delete. Wie in der Praxis sind Befehle, Programmausgaben und die Übungsdaten englisch; Aufgaben, Erklärungen, Varianten und Stolperfallen sind auf Deutsch.
Getestet auf aktuellem Linux, funktioniert fast überall
Alles basiert auf bash, GNU coreutils, grep, sed, awk, find, tar und den üblichen Systemwerkzeugen. Das Arbeitsbuch ist getestet unter Debian 13, Ubuntu 26.04 LTS und der RHEL-10-Familie (AlmaLinux, Rocky Linux) und funktioniert auf jedem aktuellen Linux-System, in einer virtuellen Maschine, unter WSL oder in einem Container. Einige Kapitel verwenden zusätzliche Werkzeuge – gawk, jq, yq, datamash, GNU parallel, zstd, rsync, sqlite3, dos2unix und weitere –, und die Installationsbefehle stehen sowohl für apt als auch für dnf bereit. Da Debian und Ubuntu mawk als Standard-awk installieren, verwendet das Buch GNU awk und kennzeichnet die wenigen Funktionen, die es nur in gawk gibt.
Teil I – Dateien und Navigation
Sie beginnen dort, wo jeder Administrator seinen Tag verbringt: im Dateisystem. Sie arbeiten mit Dateien, Verzeichnissen und Globbing, mit Massenumbenennungen und den Namen mit Leerzeichen, an denen so viele Skripte scheitern. Das Kapitel zu find behandelt Namen, Größen, Datumsangaben, Berechtigungen, reguläre Ausdrücke, das Überspringen ganzer Verzeichnisse, -exec und das sichere Löschen von Sicherungsdateien. Sie messen die Plattenbelegung, spüren die größten Dateien, Sparse-Dateien und Duplikate auf und räumen auf. Sie untersuchen Benutzer, Gruppen und Berechtigungen und erstellen Archive mit Kompression, Prüfsummen und rsync-Snapshots.
Teil II – Textverarbeitung
Das ist das Herzstück der Kommandozeile. Sie zeigen Text mit head, tail, cut und sed -n an und zerlegen ihn, suchen mit grep und ripgrep nach regulären Ausdrücken und sortieren, zählen, vergleichen und verknüpfen Dateien. Das Kapitel zu sed bearbeitet Konfigurationsdateien sicher: eine Zeichenkette überall ersetzen, Zeilenbereiche löschen, Kommentare und Leerzeilen entfernen, Teile mit Gruppen umordnen, CRLF-Zeilenenden in-place mit Sicherung korrigieren, eine Direktive aktivieren und einen Wert nur in einem bestimmten Abschnitt ändern. Zwei Kapitel zu awk führen Sie von Feldern und Mustern zu Berichten, Gruppierung, Aggregation und Joins. Ein Kapitel zu tr, Kodierung und Konvertierung behandelt Zeilenenden, Base64, Hex und Zahlenformate.
Teil III – Datenauswertung
Jetzt beantworten Sie echte Fragen aus echten Daten. Sie analysieren Webserver-Logs: die häufigsten Client-IPs, die Verteilung der Statuscodes, die am häufigsten angefragten fehlenden Seiten, das Datenvolumen pro IP, Fehlerquoten, ein Histogramm der Anfragen pro Stunde, Bots gegen Menschen, Schwachstellenscanner, die geschäftigste Minute und eindeutige Besucher pro Tag. Sie untersuchen Sicherheits- und Anwendungslogs: Brute-Force-Angreifer, die Benutzernamen, die sie probieren, die Nutzung von sudo, Fehler pro Dienst, die langsamsten Anfragen und Perzentile der Antwortzeiten. Sie verarbeiten CSV und tabellarische Daten mit awk, datamash und SQLite als Einzeiler, fragen JSON und YAML mit jq und yq ab und wandeln sie um – bis hin zum Erzeugen von /etc/hosts-Zeilen und der Umwandlung von JSON in YAML – und beherrschen Pipes, xargs, Schleifen und parallele Jobs, einschließlich Namen mit Leerzeichen, leerer Eingaben, tee, Arrays, der Erkennung von Fehlern innerhalb von Pipelines und paralleler Kompression.
Teil IV – Systemadministration
Diese Kapitel laufen auf Ihrem eigenen Rechner, daher ist ihre Ausgabe als systemabhängige Beispielausgabe gekennzeichnet. Unter Prozesse und Ressourcen finden Sie die größten Speicher- und CPU-Verbraucher, zählen Prozesse pro Benutzer, zeigen einen Prozessbaum an, beenden Prozesse sicher per Name, geben einen belegten Port frei, begrenzen Laufzeit und Priorität, vergleichen die Last mit der Zahl der Kerne, untersuchen einen Prozess in /proc und finden Zombies samt Elternprozessen. Systeminformationen und Hardware behandelt einen Überblick über Betriebssystem und Kernel, CPU und Arbeitsspeicher, Laufzeit und Bootzeitpunkt, Festplatten und Partitionen, die Frage, ob ein Neustart nötig ist, PCI- und USB-Geräte, die Erkennung von Virtualisierung und die größten installierten Pakete.
Sie prüfen Netzwerk und Konnektivität: Schnittstellen, das Standard-Gateway, Vorwärts- und Rückwärts-DNS, Ihre öffentliche IP, lauschende Ports mit ihren Prozessen, Verbindungen pro entfernter IP, das Testen eines TCP-Ports, HTTP-Statuscode und Zeitmessung, Download-Geschwindigkeit und den Ablauf von TLS-Zertifikaten. Mit systemd und dem Journal listen Sie fehlgeschlagene Units und aktivierte Dienste auf, lesen Logs seit einem Zeitpunkt, finden die Fehler des aktuellen und des vorherigen Boots, sehen Timer und ihren nächsten Lauf, bereinigen die Speicherbelegung des Journals, finden die gesprächigsten Units und erkennen neu gestartete Dienste. Arbeiten auf entfernten Systemen mit SSH und rsync behandelt Fingerabdrücke von Schlüsseln, Einträge in known_hosts, die Installation Ihres öffentlichen Schlüssels, einen Befehl auf vielen Hosts, Spiegeln mit rsync, tar über SSH, Portweiterleitung, Jump-Hosts, den Vergleich einer entfernten mit einer lokalen Datei und eine Lasttabelle über mehrere Hosts.
Teil V – Sicherheit, Zeit und Praxis
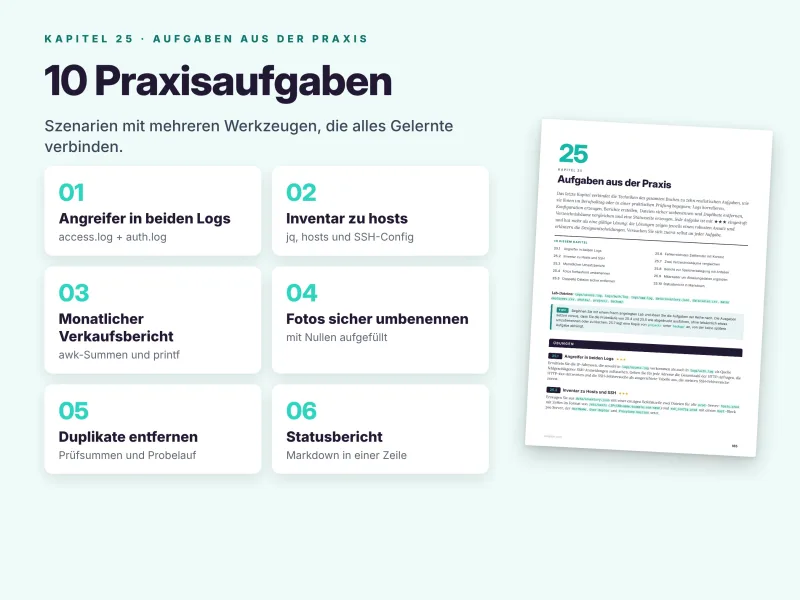
Das Kapitel Sicherheit und Auditing erzeugt starke Passwörter, verifiziert Prüfsummen, findet ungenutzte Konten mit Login-Shell, inventarisiert SUID- und SGID-Dateien, spürt für alle beschreibbare Verzeichnisse ohne Sticky-Bit auf, findet Geheimnisse in Konfigurationsdateien, prüft riskante sshd-Einstellungen, erkennt manipulierte und rückdatierte Dateien und meldet unerwartete lauschende Ports. Datum, Uhrzeit und Zeitplanung behandelt das Formatieren von Zeitstempeln, die Umrechnung von Epoch-Zeit, Bestellungen pro ISO-Kalenderwoche, das Ausschneiden eines Zeitfensters aus einem Log, Tage zwischen zwei Daten, die Umrechnung zwischen Zeitzonen, das sichere Hinzufügen eines Cron-Jobs und die einmalige spätere Ausführung eines Jobs. Zum Abschluss verbinden 10 Praxisaufgaben alles miteinander: Angreifer, die in beiden Logs auftauchen, ein Inventar, aus dem Hosts- und SSH-Einträge werden, ein monatlicher Umsatzbericht, fortlaufend umbenannte Fotos, das sichere Entfernen doppelter Dateien, das fehlerreichste Zeitfenster mit Kontext, der Vergleich zweier Verzeichnisbäume, ein Bericht zur Speicherbelegung mit Anteilen, Mitarbeiterdaten, die um Abteilungsdaten ergänzt werden, und ein Statusbericht in Markdown.
So ist jedes Kapitel aufgebaut
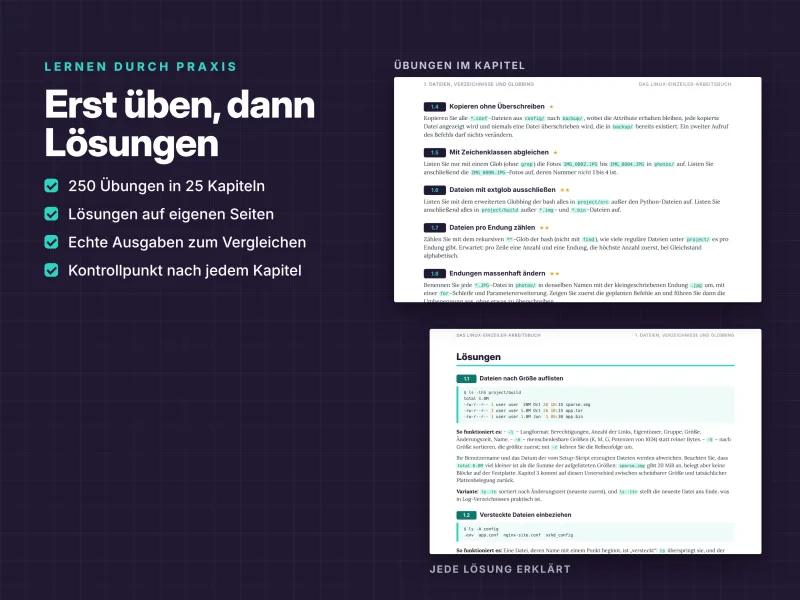
Jedes Kapitel folgt demselben Muster:
- Einleitung – was Sie üben und welche Werkzeuge Sie benötigen;
- Lab-Dateien – die Dateien, mit denen die Übungen arbeiten, bzw. Ihr eigenes System in den Administrationskapiteln;
- Übungen – zehn Aufgaben, jeweils gekennzeichnet als Grundlagen, Fortgeschritten oder Profi, sodass Einsteiger wie erfahrene Anwender eine Herausforderung finden;
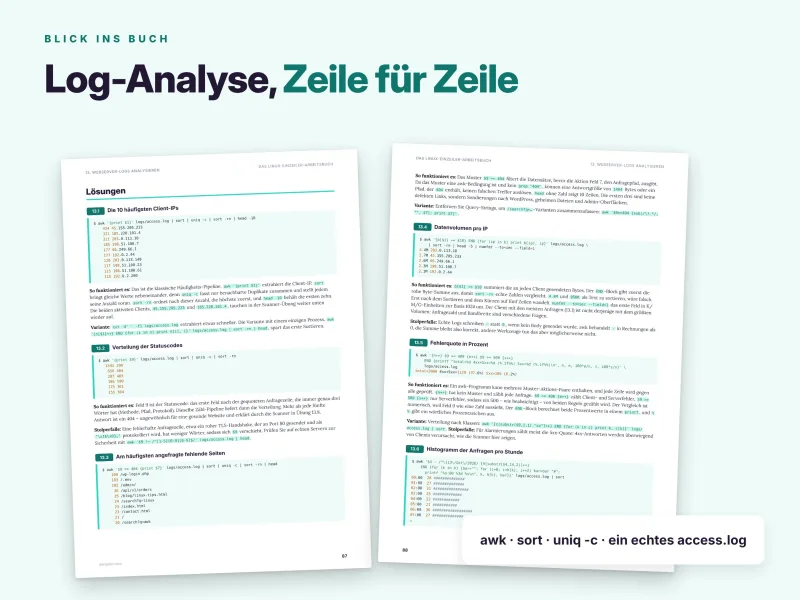
- Lösungen – auf eigenen Seiten, damit Sie es zuerst selbst versuchen können: der Einzeiler, seine echte Ausgabe und eine vollständige Erklärung, oft mit einer Variante und einer Stolperfalle;
- Kontrollpunkt – die Fähigkeiten, die Sie jetzt beherrschen sollten.
Ihre Lösung muss nicht mit der im Buch übereinstimmen. Wenn sie dasselbe Ergebnis auf sichere Weise liefert, ist sie richtig – vergleichen Sie beide und übernehmen Sie die besseren Ideen.
Eine Kostprobe: Wer greift den SSH-Server an?
Übung 14.1 verlangt, in logs/auth.log die Failed password-Ereignisse pro Quell-IP-Adresse zu zählen, den aktivsten Angreifer zuerst. Die Lösung ist eine Zeile:
awk '/Failed password/ {print $(NF-3)}' logs/auth.log | sort | uniq -c | sort -rn
Die Ausgabe ordnet die vier Angreifer im Labor, angeführt von 45.155.205.233 mit 248 Fehlschlägen. Die Erklärung zeigt, warum das funktioniert, wo einfachere Versuche scheitern. Zeilen zu fehlgeschlagenen Passwörtern gibt es in zwei Formen – … for root from IP port N ssh2 und … for invalid user NAME from IP port N ssh2 –, daher steht die IP-Adresse von links gesehen nicht an einer festen Position. Von rechts gesehen ist sie jedoch immer das vierte Feld, und $(NF-3) spricht sie an: NF ist die Anzahl der Felder, und die Klammern sorgen dafür, dass awk NF-3 als Feldnummer auswertet. Vom Zeilenende her zu zählen ist eine robuste Technik, wann immer der Zeilenanfang variiert.
Die Variante zeigt dieselbe Extraktion mit grep -oP und \K, das alles verwirft, was davor gematcht wurde. Spätere Übungen im selben Kapitel bauen darauf auf: die Benutzernamen, die Angreifer probieren, das Angriffszeitfenster pro IP mit erstem und letztem Zeitstempel, eine Schwellenwertprüfung im fail2ban-Stil mit Fehlschlägen pro voller Stunde sowie Durchschnitt und 95. Perzentil der Antwortzeit pro Dienst. So ausführlich ist das gesamte Buch: nicht nur ein Befehl, der funktioniert, sondern die Überlegung, mit der Sie den nächsten selbst schreiben.
Goldene Regeln für Einzeiler
Neben den Übungen vermittelt das Arbeitsbuch die Gewohnheiten, die Einzeiler sicher machen:
- Erst schauen, dann ändern – führen Sie zuerst
ls,find … -print,echo mv …odersedohne-iaus; - alles in Anführungszeichen setzen – Variablen, Dateinamen und Muster;
- Nullbytes als Trennzeichen für Dateilisten verwenden, mit
find … -print0 | xargs -0; - Pipelines Schritt für Schritt aufbauen und die Zwischenausgabe mit
headprüfen; - die eigene Locale kennen –
LC_ALL=Cmacht die Sortierung vorhersagbar; - Exit-Codes prüfen mit
$?,set -o pipefailund&&; - lesbar statt raffiniert.
Was dieses Arbeitsbuch auszeichnet
- Üben zuerst. 250 Übungen statt einer Befehlsreferenz – Sie lösen Aufgaben, bevor Sie die Antwort lesen.
- Echte Daten, reproduzierbare Ergebnisse. Dank des deterministischen Labors ist die Ausgabe im Buch exakt die Ausgabe auf Ihrem Bildschirm.
- Jede Lösung erklärt. Jede Option, jedes Muster und jede Pipe wird erklärt, mit Varianten und Stolperfallen, die alternative Werkzeuge und häufige Fehler zeigen.
- Drei Schwierigkeitsgrade in jedem Kapitel. Einsteiger und erfahrene Anwender finden gleichermaßen eine Herausforderung.
- Nützlich über das Buch hinaus. Log-Analyse, Sicherheitsprüfungen, JSON-Verarbeitung und Zertifikatskontrollen sind Aufgaben, die Ihnen am nächsten Arbeitstag begegnen.
- Prüfungsnah. Ideale praktische Vorbereitung auf Prüfungen wie LFCS und RHCSA.
So arbeiten Sie mit dem Arbeitsbuch
Arbeiten Sie die Kapitel der Reihe nach durch, wenn Sie breite Routine aufbauen wollen, oder springen Sie direkt zu dem Bereich, den Sie brauchen – Textverarbeitung, Log-Analyse, JSON oder Systemadministration. Legen Sie das Labor zu Beginn jedes Kapitels neu an, versuchen Sie jede Übung selbst und blättern Sie erst dann zur Lösung um. Wenn Sie nicht weiterkommen, sind die Manpage, --help und die Lösungen früherer Kapitel Ihre besten Freunde. Zehn Übungen pro Kapitel ergeben eine angenehme Lerneinheit; mit einem Kapitel pro Tag sind Sie in weniger als einem Monat durch das gesamte Arbeitsbuch.
Nachschlagematerial für den Alltag
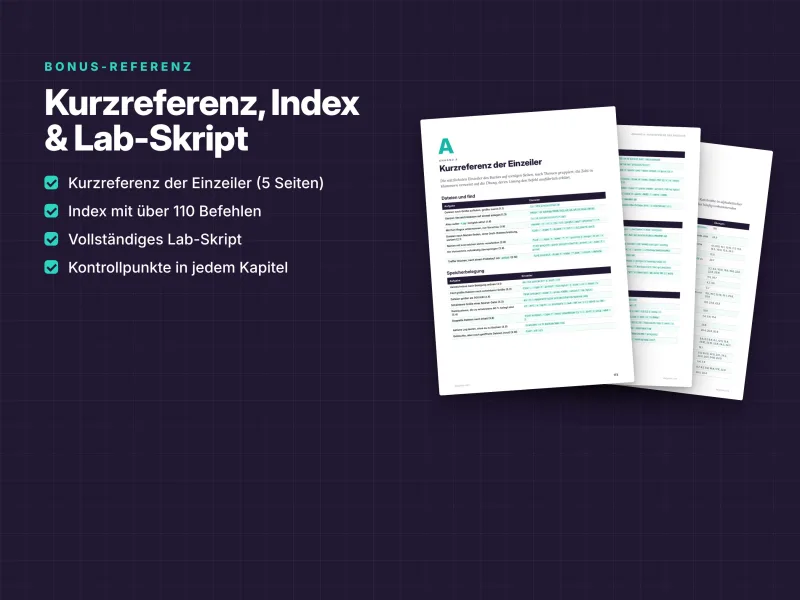
- Eine 5-seitige Kurzreferenz der Einzeiler, nach Aufgaben geordnet: Dateien und find, Speicherbelegung, Berechtigungen und Sicherheit, Archive und Sicherung, Text anzeigen und durchsuchen, Sortieren, Zählen und Vergleichen, sed, tr und Kodierung, awk, Log-Analyse, CSV und JSON, Pipes, xargs und Schleifen, Prozesse, System und systemd, Netzwerk und SSH, Datum und Zeitplanung;
- ein Befehlsindex mit über 110 Befehlen, Werkzeugen und Shell-Konstrukten, jeweils mit Verweis auf die Übungen, in denen sie vorkommen;
- das vollständige Lab-Setup-Skript, abgedruckt in Anhang C;
- ein klickbares Inhaltsverzeichnis.
Das erhalten Sie
- PDF – 187 Seiten, A4, druckbar (auch auf US Letter mit „An Seite anpassen“), mit klickbarem Inhaltsverzeichnis;
- EPUB – für Kindle, Kobo, Apple Books und andere E-Reader;
- Lab-ZIP (
Linux-Einzeiler-Arbeitsbuch-Lab.zip) –setup-lab.sh, startklar mitbash setup-lab.sh, das das komplette Übungslabor in~/linux-labanlegt; - Quellcode-ZIP (
Linux-Einzeiler-Arbeitsbuch-2026-Quellcode.zip) – alle Lösungs-Einzeiler nach Kapiteln sortiert: Die Befehle jedes Kapitels sind in Buchreihenfolge in einer Dateicommands.shgesammelt, und das Lab-Skript liegt zusätzlich alslab/setup-lab.shbei.
Nach dem Kauf laden Sie alle Dateien sofort aus Ihrem Dargslan-Konto herunter oder lesen das Buch direkt im Browser mit dem Dargslan Online Reader. Es wird nichts verschickt.
Über Dargslan
Dargslan veröffentlicht praxisnahe IT-Leitfäden für Linux-Administratoren, DevOps-Engineers und Entwickler. Jeder Dargslan-Titel ist für die Arbeit an der Tastatur geschrieben: echte Befehle, echte Daten, Übungen mit Lösungen und kein Füllstoff. Das Linux-Einzeiler-Arbeitsbuch ergänzt die Dargslan-Leitfäden zu Bash-Skripting, Linux-Distributionen, Netzwerk und Sicherheit. Auf Deutsch sind außerdem „Linux lernen“, „Das komplette Debian-Handbuch“ und „Das komplette Cloudflare-Handbuch“ erschienen.
Fangen Sie heute an
Ob Sie über die Grundlagen hinauswachsen, sich auf eine praktische Prüfung vorbereiten oder bei der Arbeit schneller Antworten aus Logs und von Servern brauchen: Dieses Arbeitsbuch macht aus Wissen über die Kommandozeile echtes Können. Hören Sie auf, über Linux zu lesen – und fangen Sie an, es zu benutzen, eine Zeile nach der anderen.
Dies ist eine unabhängige Veröffentlichung. Linux ist eine eingetragene Marke von Linus Torvalds. Alle anderen Marken gehören ihren jeweiligen Inhabern.
Who Is This Book For?
- Linux-Anwender mit Grundkenntnissen, die auf der Kommandozeile wirklich sicher werden wollen
- Systemadministratoren und DevOps-Engineers, die schneller Antworten aus Logs und von Servern brauchen
- Entwickler, die täglich unter Linux arbeiten
- Prüfungskandidaten für praktische Prüfungen wie LFCS und RHCSA
- IT-Studierende, Azubis (Fachinformatiker) und Umschüler, die Gelerntes festigen wollen
- Alle, die am besten durch Tun statt durch Lesen lernen
Who Is This Book NOT For?
- Absolute Einsteiger, die noch nie ein Terminal geöffnet haben: Beginnen Sie mit unserem Leitfaden „Linux lernen“ und kommen Sie dann zurück
- Leser, die eine Anleitung zum Schreiben längerer Shell-Skripte suchen – dafür gibt es „The Complete Bash Scripting Guide“ (auf Englisch)
- Leser, die ein erzählendes Lehrbuch wünschen – dies ist ein Arbeitsbuch mit Übungen und erklärten Lösungen
- Anwender, die ausschließlich mit Windows PowerShell arbeiten – das Arbeitsbuch verwendet bash und die GNU-Werkzeuge (WSL funktioniert)
Table of Contents
So arbeiten Sie mit diesem Buch – S. 4
Teil I · Dateien und Navigation (Kapitel 1–5)
Teil II · Textverarbeitung (Kapitel 6–12)
Teil III · Datenauswertung (Kapitel 13–17)
Teil IV · Systemadministration (Kapitel 18–22)
Teil V · Sicherheit, Zeit und Praxis (Kapitel 23–25)
- Dateien, Verzeichnisse und Globbing – S. 8
- Dateien finden mit find – S. 15
- Plattenbelegung und Aufräumen – S. 21
- Benutzer, Gruppen und Berechtigungen – S. 27
- Archive, Kompression und Backup – S. 33
- Text anzeigen und zerlegen – S. 41
- Suchen mit grep – S. 47
- Sortieren, Zählen und Vergleichen – S. 53
- Text bearbeiten mit sed – S. 59
- awk-Grundlagen – S. 65
- Berichte und Aggregation mit awk – S. 71
- tr, Kodierung und Konvertierung – S. 78
- Webserver-Logs analysieren – S. 85
- Sicherheits- und Anwendungslogs untersuchen – S. 91
- CSV und tabellarische Daten – S. 97
- JSON und YAML mit jq und yq – S. 104
- Pipes, xargs, Schleifen und parallele Jobs – S. 110
- Prozesse und Ressourcen – S. 117
- Systeminformationen und Hardware – S. 123
- Netzwerk und Konnektivität – S. 130
- Dienste und Logs mit systemd – S. 136
- Arbeiten auf entfernten Systemen mit SSH und rsync – S. 143
- Sicherheit und Auditing – S. 151
- Datum, Uhrzeit und Zeitplanung – S. 158
- Aufgaben aus der Praxis – S. 165
Anhänge
Anhang A: Kurzreferenz der Einzeiler – S. 173
Anhang B: Befehlsindex – S. 178
Anhang C: Das Lab-Setup-Skript – S. 182
Requirements
- Linux-Grundkenntnisse: ein Terminal öffnen, zwischen Verzeichnissen wechseln, Befehle ausführen
- Ein beliebiges aktuelles Linux-System mit bash und den GNU-Werkzeugen – physischer Rechner, virtuelle Maschine, WSL oder Container
- Getestet unter Debian 13, Ubuntu 26.04 LTS und der RHEL-10-Familie (AlmaLinux, Rocky Linux)
- Einige zusätzliche Pakete für manche Kapitel, etwa gawk, jq, yq, datamash, parallel und sqlite3 (Installationsbefehle sind angegeben)
- sudo-Rechte für die Kapitel zur Systemadministration